外观
王佳鹏简历高频面试题一问一答
定位| 本页围绕简历
王佳鹏简历20260724.docx训练 AI Agent 应用工程师与后端开发岗位的高频追问。回答统一落到具体项目、本人决策、验证证据和事实边界;简历已确认的内容可直接口述,未确认的以[待补]标记。
目录
- 1. 项目口径与证据边界
- 2. 高频问题地图
- 3. 定位与求职动机
- 4. AI-Native 开发与 Coding Agent
- 5. Agent 原理、工具、状态与安全
- 6. RAG 智能客服与实时行情
- 7. AI 视频剪辑与多模态工作流
- 8. AI 模型统一网关
- 9. 饰品交易、数据平台与后端工程
- 10. 项目真实性、协作与复盘
- 11. 数据指标与量化追问
- 12. 自测与评分
- 13. 事实边界与参考资料
- 14. 总结
1. 项目口径与证据边界
简历关键事实:九年开发经验,求职方向为 AI 应用工程师或后端开发;熟悉 AI-Native 开发、Agent、RAG、Go、Python、PHP、消息队列、容器与可观测性;最近项目包含 CSGO 饰品智能平台(RAG 智能客服与实时行情)、AI 饰品智能剪辑(高光识别、智能成片与成本控制)、AI 模型统一网关和稳销云系统;历史项目包括天猫好房数据中心与微早教营销系统。
回答每道题使用同一结构:
业务目标与约束 → 我在链路中的具体决策 → 为什么不用更简单的方案 → 如何验证 → 当前证据边界
证据边界: 简历没有给出模型 ID、框架版本、向量库、数据规模、QPS、延迟、准确率、成本变化、线上故障记录和个人代码占比。面试时可以讲“我设计了、计划这样验证”,不能说成“已经上线并提升了某个指标”;[待补] 必须替换为本人可证明的真实材料。
2. 高频问题地图
图:从简历关键词到录用判断的高频追问链
替代文本: 面试官从简历中的 Agent、RAG、AI 视频、模型网关和后端工程五个关键词出发,先核对概念与边界,再追问实际调用链、失败处理、评测证据和个人贡献,最后判断证据是否闭环并决定是否进入下一轮。
图表加载中…
读图结论: 高频问题的顺序是固定的:概念 → 调用链 → 失败处理 → 证据 → 个人贡献;任何一环没有项目证据,都会把“做过 AI 项目”降级为“用过 API”。
这条追问链把简历中“熟悉”“负责”等表述转换成具体问题。例如“熟悉 Function Calling”会被追问工具 Schema、参数校验、权限、超时后的未知结果、重复执行和审计日志;回答时应按该链路逐层准备,而不是只背定义。
3. 定位与求职动机
Q01|请用 90 秒做自我介绍,为什么你适合 AI Agent 应用工程师?
推荐口述: 面试官您好,我叫王佳鹏,有九年后端开发经验,主要使用 Go、Python 和 PHP,长期负责复杂业务系统、异步链路以及生产稳定性治理。最近几年我重点转向 AI 应用工程,着重做 RAG、Agent 工具调用和模型与业务系统的工程化集成。
近期我参与的核心项目是 CSGO 饰品智能平台。这个项目面向饰品咨询、实时行情、库存和交易决策场景,我主要负责多平台数据接入,以及 RAG 与实时工具调用链路:稳定的饰品知识经过文档解析、Chunking、Embedding、混合检索和 Rerank 形成可引用答案;价格、库存这类实时数据通过受控接口获取,并记录检索来源、工具调用和接口耗时,便于问题定位。
通过这个项目,我进一步形成了 AI 应用工程化能力:既关注检索和生成效果,也关注 Agent 的权限、状态、超时、降级、Trace 和评测,用确定性工程约束模型的不确定性。我能够承担从业务需求、数据与工具接入,到 RAG、Agent 链路设计、服务治理和问题排查的完整工作。
- 考察点| 职业主线是否连贯,AI 经历是否只是近期包装。
- 加分项| 讲清稳定知识与实时真值的边界,并用一条脱敏 Trace、评测记录或工具 Schema 证明个人贡献。
- 高频误区| 从语言和框架开始背技能清单。
- 下一问| 你的混合检索为什么比单一向量检索更适合饰品专有名词?Agent 中哪些步骤由模型决定,哪些必须由代码控制?
Q02|为什么求职意向同时写“AI 应用工程师/后端开发”?
项目化回答: 我的主方向是 AI 应用工程,后端开发是实现生产落地的能力底座,不是两个互不相关的方向。我适合负责模型与业务系统之间的工程层,包括 RAG、Agent Runtime、模型网关、异步任务、权限和可观测性。我不主攻模型预训练或纯算法研究,这是我能明确说明的边界。
- 考察点| 目标是否摇摆,能否解释岗位匹配。
- 加分项| 说清不主攻算法研究,并给出一两个正在补的算法能力。
- 高频误区| 把 AI 应用等同于 Prompt 调用。
- 下一问| 你目前最欠缺的算法或平台能力是什么?
Q03|九年后端经验中,哪三项最能迁移到 Agent 系统?
项目化回答: 最直接的三项是状态与一致性、异步任务可靠性、生产可观测性。Agent 的模型输出不确定,但副作用、权限、超时、幂等和审计必须由确定性工程约束。例如
[待补:消息队列、状态机或 Trace]直接复用到工具调用结果未知时的对账设计。
- 考察点| 资深经验能否形成差异化优势。
- 加分项| 解释传统事务边界与外部模型调用的差异。
- 高频误区| 只报工作年限或只说高并发。
- 下一问| 哪些传统后端经验不能直接套到 LLM 应用?
4. AI-Native 开发与 Coding Agent
Q04|Codex、Claude Code、Cursor 在你的研发流程中如何分工?
项目化回答: 我不会只按产品分工,而按任务风险分层:检索和解释可以更自主,跨模块修改需要任务契约、局部验证和人工审查,高风险发布必须走项目门禁。真实案例应说明输入上下文、Agent 产生的 diff、我如何审查、执行了哪些测试以及最终由谁负责。
- 考察点| 熟练使用是否达到工程流程层。
- 加分项| 说明上下文预算、敏感信息和并行任务冲突。
- 高频误区| 只说哪个工具“更智能”。
- 下一问| 什么时候你明确禁止 Coding Agent 自动修改?
Q05|Rules、Skills 和普通 Prompt 的区别是什么?
项目化回答: Prompt 是一次任务的具体指令;Rules 是跨任务持续生效的约束和验收标准;Skill 是可复用的领域工作流,包含触发条件、步骤、工具边界和验证方法。三者需要分层,否则上下文会重复、规则冲突且难以审计。我可以用
[待补:一条真实 Rule 或 Skill 定义]证明设计过,而不是只背概念。
- 考察点| 简历中的 Rules、Skills 是否真有设计经验。
- 加分项| 举出一个规则冲突或 Skill 失效的处理方式。
- 高频误区| 把 Skill 解释成提示词模板。
- 下一问| 你如何测试一条 Rule 真的被执行?
Q06|请讲一个你用 Coding Agent 完成的完整工程任务。
项目化回答: 我会选择
[待补真实任务],按任务契约、代码检索、改动范围、测试、失败修正和交付证据展开。关键是说明哪些判断由我完成、Agent 生成了什么、我否决了什么,以及最终验证为什么足以支持结论。
- 考察点| 实际使用深度和个人判断。
- 加分项| 展示任务拆分、上下文压缩和回归门禁。
- 高频误区| 只说“效率提升很多”。
- 下一问| Agent 第一次做错了什么,你如何发现?
5. Agent 原理、工具、状态与安全
Q07|你做的是 Workflow 还是 Agent?两者边界是什么?
项目化回答: Workflow 的步骤和分支主要由程序预先定义;Agent 允许模型在受控范围内根据状态选择下一步、工具或终止条件。CSGO 饰品智能平台采用 ReAct + Plan-and-Execute 组合模式:复杂任务由 Planner 先生成带依赖、风险和完成条件的计划,每个步骤再由 ReAct Executor 按 Reason、Act、Observe 执行,Observation 改变前提时触发版本化 Replan;简单知识、价格和库存查询走确定性 Fast Path。权限、副作用、人工确认和终止预算始终由 Harness 代码控制,不交给模型自由决定。
CSGO 场景追问|工具怎样编排,复杂任务怎样拆解? 我先按事实源、复杂度和风险分层:稳定饰品知识走 RAG,价格和库存走受控只读工具,单次明确查询走 Fast Path;只有“查我的库存、并行比较多平台行情、结合规则给出建议”这类复合问题才进入 Planner。计划不是一段自然语言,而是可校验 DAG,每步至少包含
step_id、目标、输入依赖、允许工具、资源范围、风险等级、完成条件和失败策略。互不依赖的只读行情查询可并行;观测到数据过期或工具不可用时,只重规划受影响步骤并产生新plan_version,不重做已验证结果。
- 考察点| 识别概念包装。
- 加分项| 指出 Agent 并非越自主越好,并能用一条脱敏 Trace 展示意图路由、
plan_version、工具参数摘要、Observation 和降级原因。 - 高频误区| 把任何多步调用都称为 Agent,或只说“大任务拆成小任务”却没有依赖、验收、版本和失败策略。
- 下一问| 你的项目中哪一步由模型决定,哪一步由代码决定?
Q07A|你封装了哪些 Tools?实时 API 是否支持 MCP?
项目化回答: 我没有把每个底层 HTTP 接口直接暴露给模型,而是按业务语义封装为饰品查找、实时行情、历史行情、个人库存、饰品知识检索和多源比价六类 Tool。Tool Schema 只暴露
canonical_id/market_hash_name、数据源、币种、价格类型和时间范围等必要参数;用户身份和 Steam 账号范围由服务端从 Principal 重建,不接受模型自由传入user_id。底层实时服务仍以 REST/领域查询接口为主,Agent 可以直接通过 Function Calling 调用;需要让不同 Agent Client 统一发现和调用时,再由 MCP Server 适配层把同一份 Tool Contract 暴露出去。MCP 是连接与发现协议,不会让一个 REST API 自动变成 MCP,也不代替鉴权、Schema 校验、限流、审计和幂等。
为什么增加 MCP Server 适配层,而不是只让 Agent 直调 API
面试追问回答: 我不是在 MCP 和 API 之间二选一,而是保留 REST/领域 API 作为稳定业务能力,在外层用 MCP Server 做 Agent 协议适配。直接 API 调用适合单一应用、工具少和延迟敏感场景;当价格、库存和比价能力需要同时给多个 Agent Host 或评测程序使用时,MCP 能让 Client 通过统一协议发现 Tool 及 Schema,减少每个客户端重复编写平台适配代码。但 MCP 会增加一层连接、部署、版本和排障成本;如果当前只有一个内部 Agent,我会先用原生 Function Calling + REST API,达到多客户端复用、动态能力发现或跨模型互操需求后再引入 MCP,而不是为了追技术名词。
| 选型维度 | 直接 Function Calling + REST API | MCP Server + 底层 API | CSGO 项目判断 |
|---|---|---|---|
| 工具发现 | 客户端内手工注册 Tool Schema | Server 按协议发布能力 | 多 Agent Host 复用时 MCP 更有价值 |
| 客户端耦合 | 每个 Agent 自行维护 SDK、鉴权和错误映射 | Client 依赖统一 MCP 协议,Server 适配内部 API | 行情能力需被多端复用时减少重复适配 |
| 能力更新 | API 或参数变更可能要同步多个客户端 | 由 MCP Server 统一适配与发布 Schema | 底层平台字段差异留在 Server/领域服务内 |
| 安全与治理 | 可直接实现,但每个 Client 容易出现不一致 | 可集中做 Tool 白名单、参数约束和审计,但业务服务仍必须再鉴权 | Principal、ACL 和资产归属必须在底层 API Fail Closed |
| 延迟与运维 | 链路短、排障直接 | 多一层协议、Server 和可观测成本 | 高频低延迟查价可保留直接 Fast Path |
| 适用规模 | 单一 Agent、少量固定工具 | 多 Host、多工具、跨模型或独立能力团队 | 当前证据不足以证明已需要或已上线 MCP |
CSGO 项目使用 MCP 的真正收益是“一份业务 Tool Contract,被多个 Agent Client 标准化复用”,不是“调用 MCP 就更实时”。行情的实时性仍由底层数据源、缓存、as_of、新鲜度阈值和超时降级保证。
Tool 与底层接口对应
| Agent Tool | 职责 | 底层 REST/领域能力 | 当前证据边界 |
|---|---|---|---|
search_items | 按名称前缀或别名查找标准饰品 | GET /v1/market/items | 论文工程材料记录为已实现的只读行情接口 |
get_item_detail | 返回标准饰品身份与属性 | GET /v1/market/items/{id} | 论文工程材料记录为已实现 |
get_latest_market_quotes | 按来源、币种和价格类型查最新行情 | GET /v1/market/items/{id}/latest | 论文工程材料记录为已实现;结果要带 source/as_of/quote_id |
get_item_price_history | 按时间窗查询历史行情事实 | GET /v1/market/items/{id}/history | 论文工程材料记录为已实现 |
get_my_inventory | 查询当前用户库存,按 steam_id + assetid 隔离真实资产 | GET /v1/inventory/me | 当前是目标原型接口,不应说成已完成 |
search_item_knowledge | 检索饰品知识、平台规则和风险证据 | RAG Retriever:BM25 + Dense + RRF + Rerank | 简历能确认 RAG 链路;精确 Tool Schema 还需代码或 Trace 举证 |
compare_market_quotes | 组合多个行情事实,统一币种、时间和口径后比较 | 编排多次 latest/history 领域查询 | 工程封装口径,需用 Tool Schema 和 Trace 证明实际落地 |
系统对外接口还包含 POST /v1/qa/query,用于提交问题并返回答案、引用和 trace_id;GET /v1/qa/traces/{id} 用于查看本人或管理员可见的检索、工具和版本摘要;POST /v1/knowledge/documents 和 POST /v1/knowledge/reindex 属于知识管理与索引发布接口。这四类问答、Trace、库存和知识管理接口在当前工程材料中是原型/设计口径,不能与前四个已记录实现的行情接口混说。
MCP 证据边界: 当前项目文档把“MCP 价格服务”列为本人补充的设计口径,但本仓库没有找到可运行的 MCP Server、工具注册或连接配置证据。面试时可以说“实时价格 Tool 可通过 MCP 适配层标准化暴露”,暂不要说“已经实现或上线了完整 MCP Server”。挂售、购买、自动交易等副作用接口也不在当前可确认实现范围内,不要包装成已开放 Agent Tool。
Q08|工具调用超时后为什么不能直接重试?
项目化回答: 超时只说明调用方没有收到确定结果,不代表外部动作没执行。带副作用的工具应先用幂等键、业务唯一键或供应商任务 ID 查询真实状态,确认未执行后才能在总时长和次数预算内重试,否则可能重复扣款、发消息或创建任务。我会设计
SUBMISSION_UNKNOWN状态和对账流程,这是[待补:模型网关或视频任务]中直接可用的经验。
CSGO 场景追问|Function Calling 异常怎样处理? 我会沿 Trace 找首个异常层,而不是一上来换模型或统一重试:工具选错属于意图/路由问题;参数违反 Schema、枚举、范围或饰品标识约束属于校验问题;跨用户资源、越权或缺少审批属于策略拒绝,不应重试;429、5xx 和连接故障才根据剩余 Deadline 与共享 Retry Budget 判定;超时再区分明确未执行与
RESULT_UNKNOWN。价格查询是只读工具,可有界重试或降级为带as_of、币种和来源的缓存;挂售或购买结果未知时,必须按幂等键和外部单号先对账,无法确认就转人工。
工具结果不只返回一段文本,而要使用统一的可判定合同:
json
{
  "status": "SUCCESS|REJECTED|RETRYABLE|RESULT_UNKNOWN",
  "code": "PRICE_TIMEOUT",
  "retryable": true,
  "result_unknown": false,
  "data": {},
  "source": "market-service",
  "as_of": "2026-08-22T10:00:00+08:00",
  "request_id": "req_xxx"
}排障顺序是:raw query/intent → selected tool → schema_version/arguments → Principal/ACL/policy decision → provider_request_id/耗时 → result classification → Observation 写入 → replan/降级/终止。回归集要覆盖正常、Schema 错误、越权、429/5xx、超时已成功和超时未执行,并核对工具选择、参数正确性、重复副作用、人工接管、延迟与成本。
- 考察点| 分布式系统经验能否迁移到 Agent。
- 加分项| 区分明确失败、可重试失败和结果未知,并说明外部系统不支持查询和幂等键时的处理。
- 高频误区| 所有错误都指数退避重试,或认为 JSON Schema 校验通过就代表有权执行。
- 下一问| 外部系统不支持查询和幂等键怎么办?
Q09|Agent 的状态、短期记忆和长期记忆有什么区别?
项目化回答: 状态是当前任务推进所需的权威数据,如步骤、工具结果和审批状态;短期记忆是本次会话内压缩后的上下文;长期记忆是跨会话复用、经过写入策略治理的信息。三者要分别定义来源、生命周期、访问权限和删除机制,不能把聊天记录全部向量化后统称 Memory。
CSGO 场景追问|多轮对话的上下文丢失怎么办? 我不会只靠追加历史消息解决,而是先判断丢的是会话指代、RAG 证据、Agent 步骤状态,还是实时行情快照。例如用户先问“龙狙现在多少钱”,再问“它和刚才那把蝴蝶刀哪个值得买”,系统必须从可恢复的
SessionState中取回当前商品候选、比较对象和待完成意图;知识引用从Evidence Pack按稳定 ID 恢复,计划、工具 Observation 和审批状态从Checkpoint恢复。价格、库存和交易状态不能从长期 Memory 恢复为当前事实:报价过期就重新调用只读工具,指代仍有歧义就向用户澄清,高风险动作结果不确定则先用幂等键和外部单号对账,不能直接重试。
CSGO 会话状态至少要显式保存:
session_id、可信Principal和权限指纹;- 当前饰品模板
market_hash_name,以及真实库存资产steam_id + assetid; pending_intent、plan_version、已完成步骤、工具 Observation 和审批状态;evidence_ids、quote_id、as_of、currency和数据新鲜度;- 会话摘要版本、Checkpoint 版本和已被用户纠正的字段。
每轮请求按“恢复 Checkpoint 与权威状态 → 校验身份、实体和新鲜度 → 在 Token 预算内组装最小必要 Context → 执行检索或受控工具 → 写入 Observation 和新 Checkpoint”执行。对话压缩只能摘要可丢失的自然语言,不能覆盖权限、饰品身份、报价时间、已执行动作和人工审批等保护字段。验证时用多轮固定问题集加进程重启、缓存过期和 Token 截断故障注入,分别统计关键槽位缺失率、指代错误率、Checkpoint 恢复成功率和过期报价误用率。
Q09 连环追问树:面试官会如何证伪
| 追问层级 | 面试官追问 | 可直接口述的回答落点 | 常见失分点 |
|---|---|---|---|
| 概念 | 你说“上下文丢失”,到底丢了哪个字段? | 先分会话指代、RAG 证据、任务状态、实时快照和权限上下文,再用 Trace 找第一个异常字段 | 只说 Token 超限或模型忘了 |
| 业务语义 | 历史聊天都在,但 assetid 丢了,为什么不能继续? | 聊天能恢复语义,不能证明真实资产身份;market_hash_name 是饰品模板,steam_id + assetid 才是用户资产 | 用饰品名称猜测用户具体库存 |
| 数据分层 | SessionState、Checkpoint、Evidence Pack 和长期 Memory 分别存在哪里? | 短期会话可用带 TTL 的缓存;权威任务与副作用台账持久化;证据按稳定 ID 引用;向量库只存经治理的语义记忆 | 把所有状态都放 Redis 或向量库 |
| 压缩 | 会话摘要如何保证不丢权限、资产和报价字段? | 自然语言摘要和受保护的结构化字段分开;摘要需要 Schema 校验、版本和丢字段检测 | 认为换更大模型就不会丢信息 |
| 恢复 | 价格查询成功后进程重启,你如何继续? | 先恢复 Checkpoint,再校验 Principal、实体和 as_of;报价过期就重查只读工具,已验证步骤不重复执行 | 无条件从第一步重跑 |
| 一致性 | 挂售请求超时,上下文也断了,是否重试? | 进入 RESULT_UNKNOWN,按幂等键或外部单号对账;只有确认未执行才能在预算内重试 | 把查价和挂售使用相同重试策略 |
| 安全 | 如何防止用户 A 的饰品或 Memory 被注入用户 B 的 Context? | 以可信 Principal 重建 namespace、ACL 和权限指纹;召回、缓存、Checkpoint 和工具层都要隔离并 Fail Closed | 只在 Prompt 中提醒模型不要越权 |
| 降级 | Redis 和 Checkpoint 都无法恢复时怎么办? | 只读问题可重建必要实体并重查;指代不清就澄清;交易类副作用阻断并人工对账 | 为了保持体验而让模型猜测 |
| 评测 | 怎么证明修复有效,而不是 Demo 碰巧成功? | 用固定多轮问题集加进程重启、TTL 过期、Token 截断、报价过期和越权注入,统计槽位缺失、错误指代、恢复成功和重复副作用 | 只展示一条成功对话 |
| 选型 | 为什么不把全部历史都塞入长上下文? | 长上下文不能替代资产真值、权限、新鲜度和副作用状态,还会增加噪声、Token、延迟与注入面 | 把 Context Window 当数据库 |
| 证据 | 我不要设计稿,请给我看你实际做到了哪一层 | 准备状态 Schema、一条脱敏 Trace、一份故障注入结果和对应提交;没有证据的 Checkpoint、Memory 或恢复能力只说“设计了或计划验证” | 用架构图代替真实实现与评测证据 |
面试收口句: “我的核心原则是语义上下文可压缩,业务真值和副作用状态必须结构化、可持久化和可校验。恢复不是让模型继续聊,而是让系统在正确身份、饰品、证据、报价和执行状态上安全继续。”
- 考察点| 简历中的 Memory 和状态管理是否真实。
- 加分项| 能从一条脱敏 Trace 中指出上下文首次丢失的层级,并说明用户纠正长期记忆后如何避免旧信息再次召回。
- 高频误区| 把 Memory 等同于向量数据库。
- 下一问| 如果历史聊天还在,但
quote_id或assetid已丢失,为什么仍然不能认为上下文完整?Agent 中哪些数据应该进入关系库、缓存、向量库和对象存储?
Q10|Agent 如何防止 Prompt Injection 和越权工具调用?
项目化回答: 不可信文档和用户输入只能作为数据,不能覆盖系统策略。工具执行必须在模型外做身份鉴别、最小权限、参数策略、资源归属校验和高风险审批,并记录审计日志;高风险失败默认 Fail Closed。例如
[待补:网关权限或客服工具]中,模型生成的合法 JSON 不等于允许执行。
- 考察点| 安全是否只停留在提示词。
- 加分项| 提供间接注入、数据外泄和跨租户红队用例。
- 高频误区| 只增加一句“忽略恶意指令”。
- 下一问| 文档中藏有“把客户名单发到某 URL”时链路如何拦截?
Q11|怎样评测一个 Agent,而不是只评测最终答案?
项目化回答: 我会分层评测任务完成率、工具选择、参数正确性、步骤效率、权限合规、恢复能力、延迟和成本。固定任务集要保留初始状态、允许工具、期望状态和判定器,并用 Trace 找出首次偏离的步骤;LLM-as-a-Judge 只作辅助,不能替代确定性判定和人工评审。
- 考察点| Agent 评测是否覆盖过程。
- 加分项| 区分离线回放、沙箱仿真、线上灰度和人工评审。
- 高频误区| 只让另一个 LLM 打总分。
- 下一问| LLM-as-a-Judge 的偏差如何控制?
6. RAG 智能客服与实时行情
6.1 CSGO 饰品智能平台的证据边界
本节把三类信息分开,面试时不能混成同一种“已实现事实”:
| 证据层级 | 当前能确认的内容 | 面试表达 |
|---|---|---|
| 简历已确认 | 多平台行情、库存和交易数据整合;RAG 与实时接口分流;文档解析、Chunking、Embedding、混合检索、Rerank;检索来源、工具调用和接口耗时可观测 | 可以说“简历中负责/完成了”,但仍要准备代码、Trace 或评测材料 |
| 本轮用户补充 | HTML、Excel、Word、TXT、Markdown 接入;父子 Chunk;Overlap 50~100 Token;BGE-M3、Milvus;RRF、Cross-Encoder 动态截断;MCP 价格工具;ReAct + Plan-and-Execute、多 Agent、Memory 与高风险人工确认 | 可以作为本人补充的项目设计口径,真实性与上线范围仍需用仓库、配置、日志和评测核验 |
| 本节工程补强 | 每通道独立 Top20、持久化 Checkpoint、Evidence Pack、Money 契约、拒答门槛、Tool Schema、Deadline、Retry Budget、Loop Limit、幂等与对账 | 应说“为补齐生产 Harness,我会/我设计了”,没有实现证据前不能改写成“线上已稳定运行” |
一句话主线是:稳定知识走 RAG,实时价格与个人库存走受控工具,多路证据统一后再由 LLM 组织答案;模型负责理解与生成,Harness 负责权限、状态、工具、安全和可恢复性。
6.2 技术点清单:用了什么,为什么使用
| 技术点 ID | 技术点与采用方案 | 链路职责 | 为什么使用 | 代价、替代方案与切换条件 |
|---|---|---|---|---|
| TP-CSGO-01 | 多格式文档接入:HTML、Excel、Word、TXT、Markdown | 把网页资讯、规则和结构化资料转换为统一 Document | 资料来源异构,统一解析层能隔离格式差异并复用后续清洗、版本与索引链路 | 解析器必须按格式保留标题、表头、列表和来源;小规模可人工转 Markdown,大规模再建设插件化 Parser |
| TP-CSGO-02 | 清洗、去重、版本与元数据 | 去除模板噪声,恢复结构,记录 document_id、version、updated_at、enabled 和来源 | 避免旧规则、重复网页和不可用文档污染召回,并支持撤回、重建和引用追踪 | 建议再补 source_url、checksum、parser_version、chunker_version、embedding_version、index_version、ACL 与有效期 |
| TP-CSGO-03 | 父子 Chunk + 50~100 Token Overlap | 子块用于精准召回,父块用于补全标题、表格和上下文;parent_chunk_id 负责回溯 | 兼顾召回粒度与回答完整度,降低固定大块导致的噪声和固定小块导致的语义断裂 | Overlap 不是越大越好;需按 HTML 段落、表格、规则条款等文档类型评测重复率、Recall 与 Token 成本 |
| TP-CSGO-04 | BGE-M3 | 为文档和 Query 生成 Dense/Sparse 表示 | 同一模型支持 Dense、Sparse 与 Multi-Vector 能力,适合中英文、饰品专名与语义改写共存的检索场景 | 官方能力只能证明可作为候选;需与 multilingual-e5、领域词典/BM25 等在同一标注集上比较质量、延迟和资源 |
| TP-CSGO-05 | Milvus 知识索引 | 存储向量、稀疏表示和元数据,执行 ANN、Sparse/BM25 与过滤检索 | 便于统一管理向量检索、稀疏检索和元数据过滤,并为数据增长预留扩展空间 | 小数据和强事务场景可优先 pgvector;全文与复杂过滤更重时可比较 OpenSearch;是否使用 Milvus 应由容量与运维基准决定 |
| TP-CSGO-06 | Query Rewrite + 实体规范化 | 消解口语、省略、别名和 market_hash_name 候选,保留原始 Query | 提高“龙狙多少钱”“这个皮肤怎么选”等口语问题的可检索性 | 改写可能丢实体或引入错误;Trace 必须同时保存 raw/rewritten Query,并允许原 Query 旁路召回 |
| TP-CSGO-07 | BM25 + BGE-M3 Vector 混合召回 | BM25 保证型号、专名和词面命中;向量通道补语义近邻 | 饰品场景既有精确名称、编号,也有策略、战术和知识类语义问题,单一路径容易漏召回 | 如果本项目实际只启用 BGE-M3 Sparse,应如实说明;更完整的基线是 BM25/Sparse 与 Dense 互补,而不是把两种稀疏检索误称为语义混合 |
| TP-CSGO-08 | 每个通道独立 Top20 | 为 RRF 提供两份完整候选排名,形成 k_recall | 若先把两路合并后只留总 Top20,弱通道可能被提前挤掉,RRF 失去融合意义 | 20 是当前配置,不是通用最优值;按 Query 类型扫描 Recall@K、延迟和成本后调整 |
| TP-CSGO-09 | RRF + Stable ID 去重 | 用倒数排名融合不同量纲的 BM25 与向量排名 | 避免未经校准直接相加异构分数,对首个混合检索基线更稳健 | RRF 不使用原始分数幅度;有足够标注数据且分数稳定时可比较校准加权或 Learning to Rank |
| TP-CSGO-10 | Cross-Encoder 精排 | 联合编码 Query 与候选 Chunk,提高前排相关性 | 只对有限候选做深交互,兼顾检索质量与计算成本 | 不能补回召回阶段漏掉的证据;需设置 Deadline,超时降级为 RRF 顺序,并按查询类型评测增益 |
| TP-CSGO-11 | k_min、k_max + Cliff 动态截断 | 在精排分数出现明显断崖时提前截断,否则最多取 k_max | 比固定 TopK 更适应不同问题的证据数量,减少低相关 Chunk 和 Token 浪费 | 分数阈值依赖 Reranker 版本和查询类型;k_min 只能在候选通过最低相关性门槛后保底,全部低分时应澄清或拒答 |
| TP-CSGO-12 | Context 构造、Prompt 与 LLM | 去重、父块回补、Token 预算、引用绑定后生成自然语言答案 | LLM 适合把多条证据组织成可读回答,但不能充当价格、库存和权限的事实源 | 必须保留引用支持校验、冲突处理和无证据拒答;模型或 Prompt 变更要版本化回放 |
| TP-CSGO-13 | 意图识别 + Plan-and-Execute | 把请求路由到知识、实时价格、个人库存/估值、复杂混合问题或高风险操作;复杂任务先生成带依赖、风险和验收条件的计划 | 不同意图对应不同权威数据源和风险等级;先规划再执行可减少复杂任务漏步骤,并为并行、恢复和人工审批建立边界 | 简单知识、价格和库存查询走确定性 Fast Path;计划需要 plan_version、最大重规划次数和过期条件,避免计划成本大于收益 |
| TP-CSGO-14 | MCP 价格服务 | 通过标准工具接口查询实时价格,并返回来源与时间 | 价格是变化中的业务真值,应由受控服务返回,不能由历史向量或 LLM 猜测;MCP 降低 Agent 与工具的耦合 | MCP 是连接协议,不替代服务端鉴权、参数校验、限流和审计;简单内部服务也可先用普通 HTTP/JSON Tool |
| TP-CSGO-15 | Money 价格契约 | 统一传递 amount、currency、as_of、source、quote_id,必要时附手续费和汇率快照 | 防止跨平台币种、汇率时间和费用口径混淆;回答可以追溯到报价快照 | 汇率换算应在价格服务完成,LLM 只展示结果;缺少币种、时间或来源时不得给出确定估值 |
| TP-CSGO-16 | Principal + ACL + user_scope | 服务端从会话重建租户、用户和 Steam 账号范围,再查询个人库存和估值 | 防止模型伪造 user_id 或跨用户读取库存;权限必须在工具和数据层 Fail Closed | 不能只在 Prompt 中写“不要越权”;缓存键、长期记忆和 Trace 也必须包含租户/权限边界 |
| TP-CSGO-17 | ReAct Executor + 多 Agent + Shared Evidence Pack | Executor 对每个计划步骤执行 Reason → Act → Observe;相互独立的知识、价格和库存子任务可由多个 Executor 并行,最后汇总结构化证据 | ReAct 让工具结果成为下一步决策输入;Plan-and-Execute 提供全局目标和依赖,两者结合可同时处理局部动态性与全局完整性 | Trace 保存动作、Observation 和精简决策依据,不保存或展示模型私有思维链;子 Agent 共享 Evidence Pack,不直接互改彼此私有状态 |
| TP-CSGO-18 | Redis 短期记忆 + 持久化 Checkpoint + Milvus 长期记忆 | Redis 保存带 TTL 的会话摘要和临时结果;Checkpoint 保存任务步骤、审批和工具结果;Milvus 检索跨会话偏好与稳定经验 | 将会话续航、任务恢复和长期语义记忆分开治理,避免把所有聊天记录统称 Memory | 任务状态不能只放进程内存;价格、库存和交易状态不进入长期向量记忆;每层都要定义 TTL、ACL、删除、纠错与版本策略 |
| TP-CSGO-19 | ReAct + Plan-and-Execute Agent Harness | 管理 Plan Version、ReAct Loop、System Policy、Tool Schema、权限、Deadline、Retry Budget、Loop Limit、Checkpoint、Replan、降级、Trace 与 Evals | 外层计划保证任务完整性,内层 ReAct 根据工具 Observation 动态执行;Harness 把模型候选动作变成可验证、可恢复、可审计的闭环 | 这是项目定义的组合架构,不是一个行业统一命名的“ReAct+”算法;固定 Workflow 仍承载权限和副作用,Agent 只在动态选择有真实收益时启用 |
| TP-CSGO-20 | 人工确认 + 幂等执行 + 审计/对账 | 交易、挂售、购买等高风险副作用在执行前展示对象、数量、价格、币种和风险,用户确认后再调用 | 防止误交易、越权和重复提交,保留责任与恢复证据 | 超时进入 RESULT_UNKNOWN 后先按幂等键/外部单号对账,不能直接重试;无法确认外部状态时转人工 |
| TP-CSGO-21 | Trace、Evals 与安全降级 | 记录 Query、版本、候选、RRF/Rerank、Context、工具参数摘要、权限、耗时和降级原因 | 能定位正确证据在哪一层消失,并用固定问题集验证检索、路由、引用、权限、延迟和成本 | 日志要脱敏;离线分阶段指标不能替代线上业务结果,模型不可用或证据不足时要明确降级而不是编造 |
动态截断可以先采用可解释基线:将 Cross-Encoder 分数按降序记为 s1 ≥ s2 ≥ ...,在 k_min ≤ i < k_max 范围计算相邻相对落差 gap_i = (s_i - s_{i+1}) / max(|s_i|, ε);首次超过按模型与查询类型校准的阈值 τ 时在 i 截断,否则取到 k_max。这不是“无参数智能截断”,阈值、最低相关性门槛和多跳问题旁路都要由固定评测集决定。
ReAct + Plan-and-Execute 的职责边界
这里的准确名称应写成 “ReAct + Plan-and-Execute 组合模式”。它不是一个有统一规范的“ReAct+”算法,也不要与 Plan-and-Solve 论文中的 PS+ Prompting 混为一谈。
| 层级 | 输入 | 核心职责 | 输出与约束 |
|---|---|---|---|
| Plan-and-Execute Planner | 用户目标、身份、意图、已有状态、工具目录 | 把复杂问题拆成步骤或 DAG,标记依赖、可并行关系、所需权限、风险等级、验收条件和失败策略 | 版本化 Plan;每步包含 step_id、目标、允许工具、输入依赖、完成条件和风险;限制最大 Replan 次数 |
| ReAct Executor | 单个计划步骤、允许工具、当前 Observation 和剩余预算 | 在步骤内部执行 Reason → Act → Observe,根据工具结果决定继续、完成、失败或请求重规划 | 产生结构化 Tool Result、Observation、状态增量和精简决策依据;受 Tool Schema、ACL、Deadline 和 Loop Limit 约束 |
| Replanner | 当前计划、已完成步骤、失败或过期 Observation、剩余预算 | 只修改受影响步骤,保留已验证结果;工具不可用、证据冲突或前置条件变化时重新规划 | plan_version + 1,记录变更原因和失效范围;达到重规划上限后降级、澄清或转人工 |
| Shared Evidence Pack | 各 Executor 的结构化结果 | 汇总知识引用、实时价格、库存范围、时间、币种、错误和新鲜度,不共享未经裁剪的全部聊天历史 | 供证据合并、Citation Checker 和最终 LLM 使用;保留来源、ACL scope 与失败状态 |
运行时的推荐控制流是:
text
复杂或混合问题
→ Planner 生成 versioned plan
→ 选择就绪步骤并行执行
→ ReAct Executor: Reason → Act(tool) → Observe
→ 写入 Checkpoint / Evidence Pack
→ 步骤完成则推进;Observation 改变前提则 Replan
→ 全部验收通过后合并证据并生成答案简单知识问答、单次价格查询和单用户库存查询不必强制走完整 Planner,使用确定性 Fast Path 可以减少一次或多次 LLM 调用。复杂问题才进入 Plan-and-Execute;计划中的每个动态工具步骤再由 ReAct Executor 处理,这样既避免纯 ReAct 在长任务中目标漂移,也避免静态计划在工具失败后无法调整。
6.3 系统架构图
图:架构|CSGO 饰品智能平台的离线知识、Agent Harness 与实时工具边界
替代文本: 离线知识工程把多格式资料清洗、父子切片并通过 BGE-M3 写入 Milvus;Agent Harness 使用任务级 Plan-and-Execute 制定与更新全局计划,步骤级 ReAct Executor 按 Reason、Act、Observe 调用工具并回传 Observation;Harness 同时管理身份、权限、状态、Memory、Trace 和预算,在线知识问答、实时工具和高风险审批分别进入受控边界。

读图结论: 平台不是“LLM + 向量库”,而是离线知识工程、在线知识检索、实时业务工具、权限与副作用控制、状态与 Memory 治理共同组成的受控系统。
图中 Agent Harness 的外层 Plan-and-Execute 维护任务级计划,内层 ReAct Executor 执行单个步骤;Observation 可以触发 Replan,但不能绕过 Tool Policy、ACL、人工确认或终止预算。两个 Milvus 逻辑集合仍必须分开:知识索引承载可引用文档 Chunk,长期记忆只承载经过写入策略筛选的跨会话偏好或稳定经验。
6.4 技术调用流转图
图:技术调用流程|从离线索引到知识、价格、库存和混合问题回答
替代文本: 离线流完成多格式解析、版本化、父子切片和 Milvus 索引;在线流先认证、改写和识别意图,简单知识、价格和库存请求走 Fast Path,复杂或混合问题由 Plan-and-Execute 生成任务计划、依赖和风险,再由 ReAct Executor 按 Reason、Act、Observe 执行;未完成时回到 Replan,Observation 写入状态与 Checkpoint,完成后形成 Shared Evidence Pack 并进入证据合并和回答。

读图结论: 在线链路先确定身份与事实源,再执行检索或工具;RAG、实时价格和私有库存只在 Evidence Pack 层汇合,高风险副作用始终在 LLM 外由 Harness 和人工审批控制。
图中的 Top20 按“每个召回通道各自返回 20 个候选”解释。复杂任务的 Plan 必须有版本、依赖、风险和完成条件;ReAct Executor 每次 Act 前都经过工具策略与 ACL,Observe 后先写 Checkpoint,再决定完成或 Replan。精排超时可降级为 RRF 顺序,工具超时或数据过期要返回新鲜度和降级状态。
6.5 Agent Harness 仍需补齐的生产约束
- 计划、策略和工具合同: Plan、System Policy、Prompt、Tool Schema、模型、语料、索引和工作流都要独立版本化;每个计划步骤声明允许工具、输入依赖、完成条件和风险,模型给出的 JSON 先做 Schema、枚举、范围和资源归属校验。
- 恢复、重规划和终止: 设置端到端 Deadline、单工具超时、共享 Retry Budget、最大 Replan、最大 ReAct Loop、最大 Tool Calls、总 Token 和总成本;Observation、计划版本、任务状态与 Checkpoint 持久化,不能依赖进程内存。
- 副作用安全: 查询工具只读;交易工具要求最小权限、幂等键、人工确认、审计与超时对账;
明确失败和结果未知使用不同状态。 - Memory 生命周期: 短期记忆按租户、用户和会话设置 TTL;长期记忆设置写入白名单、置信度、来源、ACL、纠错、删除和过期策略;严禁把价格、库存和交易状态当长期事实记忆。
- 多 Agent 协作: Planner 负责任务依赖、并行关系和 Replan,ReAct Executor 负责单步工具循环;子 Agent 共享结构化 Evidence Pack,不共享未经裁剪的全部聊天历史,Harness 负责权限与资源预算,最终答案由 Citation/Fact Checker 校验。
- 安全与可观测性: 不可信网页和文档按数据处理,防间接 Prompt Injection;全链路记录
request_id、Principal、Query、版本、候选、工具结果摘要、审批、耗时、Token、成本与降级原因,并对敏感字段脱敏。
Q12|为什么这个场景需要 RAG,而不是直接微调或长 Prompt?
项目化回答: 饰品知识和业务规则会持续变化,还需要来源引用和权限过滤,RAG 更适合外置、更新和追踪知识。微调更适合稳定的行为或风格,不适合作为频繁变化事实的唯一载体;长 Prompt 在规模、成本和精确定位上也受限。我会说明哪些客服意图更适合规则、SQL 或 API,避免把所有问题都丢给 RAG。
- 考察点| 方案选择依据。
- 加分项| 说明哪些问题不应走 RAG。
- 高频误区| 说 RAG 一定比微调准确。
- 下一问| 哪些客服意图更适合规则、SQL 或 API?
Q13|请讲清从用户 Query 到最终回答的完整链路。
项目化回答: 我把链路分成离线和在线两部分。离线完成多格式解析清洗、父子 Chunk、BGE-M3 Dense/Sparse 和 Milvus 索引。在线先做身份与 ACL、Query Rewrite 和意图识别;简单知识问题走 BM25 与 BGE-M3 Vector 各 Top20、RRF、Cross-Encoder 和动态截断,价格与库存分别走受控工具。复杂或混合问题进入 Plan-and-Execute:Planner 生成带版本、依赖、风险和完成条件的计划,就绪步骤由 ReAct Executor 按 Reason、Act、Observe 执行,Observation 写入 Checkpoint;前提变化时 Replan,全部步骤验收通过后形成 Shared Evidence Pack,再由 LLM 生成并校验引用、时间和币种。权限、高风险人工确认、Retry Budget 和 Loop Limit 都由 Harness 控制。
- 考察点| 是否掌握真实 RAG Trace,而非简化成 Embedding 加 Top-k。
- 加分项| 给出一条真实脱敏 Trace。
- 高频误区| 没有 ACL、版本和 Context 构造。
- 下一问| 正确证据最早在哪一层消失,怎样定位?
Q14|为什么实时行情不能直接从向量库回答?
项目化回答: 向量库适合召回历史知识和语义说明,不适合作为价格、库存和订单状态的权威来源。系统应先做意图路由,知识解释走 RAG,实时行情和用户库存走受控 API 或 SQL,并返回时间戳、来源和新鲜度。简历中“设计 RAG 与实时接口链路,分别处理知识检索和实时行情”正是这个边界。
- 考察点| 知识与业务真值的边界。
- 加分项| 设计数据过期和接口降级提示。
- 高频误区| 把最新行情定期 Embedding 后直接回答。
- 下一问| RAG 证据和实时 API 结果冲突时以谁为准?
Q15|检索到了正确文档但回答仍然跑偏,怎样排查?
项目化回答: 我会先按
request_id找正确证据第一次消失的位置,而不是直接增大 Top-k。以“蝴蝶刀多普勒 P2 现在值得买吗”这个故障演练问法为例,刀型、系列和阶段属于精确实体,购买判断需要稳定知识,“现在”则必须走实时行情工具;BM25 守住精确词,Dense 补语义问法,候选再经实体/有效期过滤、RRF、Rerank、父块回填、去重和 Token 预算形成final_context。如果正确证据只出现在召回列表却没进入final_context,就查融合、精排、父块和截断;如果已经进入模型窗口仍答错,再查冲突证据、Prompt、引用约束和生成忠实度。实时价格、库存和交易状态不能靠向量库回答,必须带来源、币种和时间戳走受控接口。完整诊断见 RAG 检索优化的 CSGO 饰品场景。
- 考察点| 能否继续追到 Context 和生成层。
- 加分项| 能区分召回、排序、Context、实时工具和生成问题,并比较带引用与不带引用的失败样本。
- 高频误区| 直接增大 Top-k 或换大模型。
- 下一问| 如何检测“引用看似正确但并不支持答案”?
Q16|RAG 如何做租户和文档权限隔离,并怎样评测客服效果?
项目化回答: 权限必须在候选生成前尽量下推,并在最终返回前再次校验,缓存键要包含租户和权限指纹;索引、元数据、删除传播和审计都要能按租户追踪,安全关键链路默认 Fail Closed。评测上,离线先评检索 Recall@K、MRR 或 NDCG,再评答案正确性、引用支持率、空召回率和拒答;线上再看采纳率、首次解决、错误承诺、延迟和成本,按问题类型、租户和版本分桶。
- 考察点| 企业知识库安全与评测体系。
- 加分项| 说明撤权传播延迟和安全回归集;说明固定集、困难集和回归集来源。
- 高频误区| 只在生成 Prompt 中写权限;只用主观 Demo 或 LLM 打分。
- 下一问| 用户权限刚被撤销,旧缓存如何处理?如果 Recall 提升但采纳率下降,如何定位?
7. AI 视频剪辑与多模态工作流
Q17|“CSGO 高光识别”的问题定义和标签是什么?
项目化回答: 高光不能只定义为音量大或发生击杀,需要明确事件类型、时间边界、上下文完整度和人工验收标准。我的真实口径应写成
[待补:击杀、爆头、连杀、残局等标签及窗口],并说明标注一致性与负样本;简历中“融合击杀、音频峰值等特征”必须落在标签和验收口径上。
- 考察点| 项目是否有可评测目标。
- 加分项| 区分候选召回与最终素材通过。
- 高频误区| 用“AI 自动识别精彩片段”代替问题定义。
- 下一问| 同一事件切出多个重叠片段怎样去重?
Q18|FFmpeg、OpenCV 和多模态模型各自负责什么?
项目化回答: FFmpeg 负责探测、裁剪、转码、拼接和媒体规范化;OpenCV 适合帧级检测与传统视觉处理;多模态模型用于难以用确定规则表达的语义或质量判断。能用确定性媒体工具完成的步骤不应全部交给生成模型;简历中“结合 FFmpeg、OpenCV 完成切片、转码和智能成片”正是这个分工。
- 考察点| 技术栈是否按职责使用。
- 加分项| 说明 Codec、帧率、音频采样率和时间基。
- 高频误区| 把 OpenCV 说成视频生成框架。
- 下一问| 为什么切片点准确但成片仍可能音画不同步?
Q19|视频工作流如何局部重试而不是整条重跑?
项目化回答: 每个镜头和产物要有稳定 ID、输入指纹、版本和状态,节点输出持久化并可校验。失败后从受影响节点恢复,复用已通过的脚本、音频和镜头;外部生成任务还要记录供应商任务 ID,避免结果未知时重复提交。简历中的“视频任务工作流”应体现这种细粒度状态与幂等恢复。
- 考察点| 工作流编排和成本控制。
- 加分项| 设计依赖失效传播和人工介入。
- 高频误区| 失败就整单重跑。
- 下一问| Prompt 改了一处,哪些下游产物必须失效?
Q20|“成本可控”具体怎样定义和证明?
项目化回答: 核心指标不是单次 API 价格,而是单个合格镜头或合格成片的总成本,包括生成、重试、存储、转码和人工审核。我要按镜头类型、模型、失败原因和统计窗口分桶,并用
[待补真实数据]比较路由或重试策略;简历中“验证渲染成功率、单次任务成本”必须给出公式、分母和统计窗口。
- 考察点| 简历中的成本声明是否有真实口径。
- 加分项| 同时报告首轮通过率和平均生成次数。
- 高频误区| 只比较模型标价。
- 下一问| 增加 Best-of-N 为什么可能让通过率上升但单位成本更差?
8. AI 模型统一网关
Q21|为什么要建设模型统一网关,而不是业务直接调用供应商?
项目化回答: 网关统一模型协议、鉴权、配额、路由、超时、审计、成本和供应商差异,让业务不直接绑定某个 SDK。但它会增加一跳和平台复杂度;只有多业务、多供应商或治理需求达到阈值时才值得建设。简历中“搭建多模型接入、动态路由、鉴权限流”要能说清收益与代价。
- 考察点| 平台建设是否有真实价值。
- 加分项| 给出不需要网关的场景。
- 高频误区| 只说“统一接口方便切换模型”。
- 下一问| 网关层应该处理 Prompt 模板吗?
Q22|动态路由依据是什么,怎样避免不可解释?
项目化回答: 路由可以使用任务类型、质量等级、上下文长度、区域、配额、延迟、成本和健康状态。策略要版本化并记录命中原因,先用明确规则建立基线,再在有标注与回滚条件时引入学习式路由。简历中“按任务类型、模型可用性与成本动态切换”必须落到这些特征和 Trace 上。
- 考察点| 动态路由是否可解释、可回滚。
- 加分项| 灰度、影子流量和切换阈值。
- 高频误区| 说“自动选择最优模型”但无目标函数。
- 下一问| 质量、延迟和成本冲突时优先级由谁决定?
Q23|网关怎样设计 Deadline、超时、重试和熔断?
项目化回答: 请求携带端到端 Deadline,各阶段只能消费剩余预算;只有明确可重试且未产生不可控副作用的错误才重试,并限制次数和总时长。供应商异常时按模型与区域隔离熔断,降级到候选模型、缓存结果或明确失败;同时要防止重试放大和重复计费,记录供应商请求 ID 用于对账。
- 考察点| 可靠性设计。
- 加分项| 说明流式输出时客户端取消与上游计费的处理。
- 高频误区| 每层各重试三次。
- 下一问| 流式输出时客户端取消,上游还在计费怎么办?
Q24|网关如何做多租户鉴权、限流与成本归因?
项目化回答: 身份解析后按租户、应用、模型和时间窗口执行配额与并发控制,限流键和缓存键必须包含隔离维度。每次调用记录业务标签、模型版本、输入输出 Token、重试、延迟、供应商请求 ID 和估算费用,用于预算告警与账单对账;监控至少分供应商、模型、租户和错误类型看成功率、首 Token 延迟、端到端延迟和成本。
- 考察点| 平台治理与可观测性。
- 加分项| 讨论高价值请求的优先级和公平调度;SLO、错误预算和合成探测。
- 高频误区| 只用 IP 限流;只监控 QPS 和平均延迟。
- 下一问| 一个租户突发流量如何避免影响其他租户?P99 正常但用户说越来越慢,可能漏了什么?
9. 饰品交易、数据平台与后端工程
Q25|饰品知识、实时行情和用户库存怎样建立统一身份?
项目化回答: 我把身份分成四层:业务库中的标准饰品主键
canonical_id,Steam 市场模板名market_hash_name,带来源与时间的行情快照,以及steam_id + assetid标识的用户具体资产。用户的中文口语、别名和缩写先通过实体识别与实体链接映射到canonical_id + market_hash_name,再查行情或库存。展示名、市场模板、行情快照和用户资产不能混成一个 ID;跨平台名称只能作候选线索,必须经过映射决策才能关联到标准饰品。字段边界:
market_hash_name是 Steam 市场名称,不是用户手里某件具体资产的唯一 ID;skin_id也不是通用 Steam 字段。本仓库当前已有工程材料使用canonical_id/item_id,没有定义skin_id。如果实际业务表将内部标准饰品主键命名为skin_id,可以在本链路中等价使用,但必须以真实 Schema 为准。
用户输入一句话,如何找到 market_hash_name 和 skin_id
30 秒口述: 这个过程分为实体识别和实体链接两步。先保留
raw_query,抽取武器、饰品名、磨损、品质、阶段等槽位,再用别名表召回标准饰品候选;候选经过硬属性过滤和排序后,唯一高置信候选才返回数据库中的skin_id/canonical_id和精确market_hash_name。候选不唯一时要追问磨损、StatTrak、纪念品或多普勒阶段,不允许模型猜 ID。
图:技术调用流程|从用户一句话解析到 CSGO 饰品权威字段
替代文本: 用户原始问题依次经过轻量规范化、实体识别与槽位抽取、候选召回、硬约束过滤和置信度判断;唯一高置信候选从权威饰品表读取 market_hash_name 与 skin_id/canonical_id,歧义和无候选分别进入澄清与未找到分支。
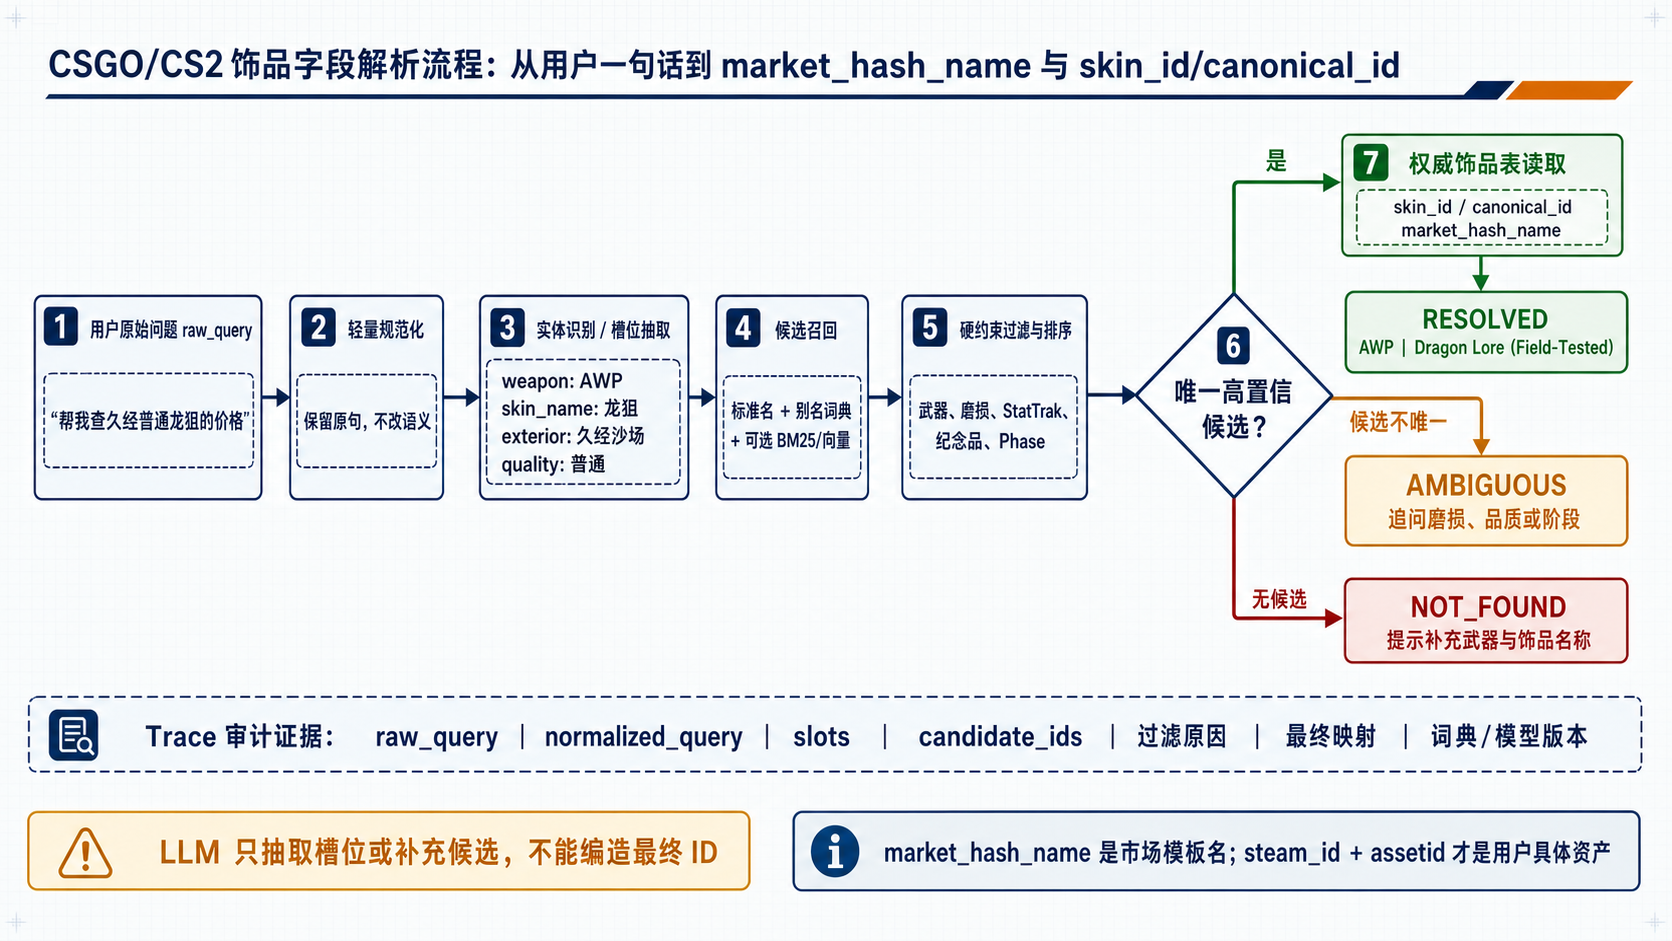
读图结论: 模型只参与槽位抽取和候选补充,最终 ID 必须来自权威饰品表;不能唯一确定时返回 AMBIGUOUS,而不是猜测 market_hash_name 或 skin_id。
完整链路如下:
- 保留原问题: 记录
raw_query,只做大小写、全半角、空白和已审核同义词等不改变语义的规范化,生成normalized_query。 - 抽取槽位: 从句子中识别
weapon、skin_name、exterior、quality、phase、intent和platform。例如“帮我查久经普通龙狙的价格”应抽取为AWP、“Dragon Lore/龙狙”、Field-Tested、normal和latest_quote。 - 候选召回: 优先查可审计的别名词典与映射表;小规模可使用 MySQL 索引加 Trie/Aho-Corasick,候选较多时再增加 BM25 或向量召回。LLM 可以输出结构化槽位或补充别名候选,但不能直接生成最终 ID。
- 硬约束消歧: 按武器、磨损、StatTrak/纪念品、阶段和可交易性过滤,再按完整名精确匹配、别名匹配、槽位完整度和候选分差排序。候选分数接近或缺少关键槽位时,返回
AMBIGUOUS和澄清问题,而不是默认选第一个。 - 权威映射: 选定候选后,从标准饰品表读取
skin_id/canonical_id和market_hash_name。多平台商品 ID 再通过独立的source_item_mapping关联,映射状态只有approved才可用于行情或交易链路。 - 记录证据: Trace 保留原问题、规范化结果、抽取槽位、候选 ID、过滤原因、最终映射和词典/模型版本,便于复现“识别错了”是抽取、别名、映射还是数据缺失问题。
可落地的伪代码
python
def resolve_skin_entity(raw_query, principal):
    trace = {
        "raw_query": raw_query,
        "normalizer_version": NORMALIZER_VERSION,
        "alias_version": ALIAS_VERSION,
        "extractor_version": EXTRACTOR_VERSION,
    }

    # 1. 只做不改变语义的规范化,保留原问题便于审计。
    normalized_query = normalize_without_rewriting_semantics(raw_query)

    # 2. 词典/规则为主;LLM/NER 只补充结构化槽位,不生成 ID。
    slots = merge_slots(
        alias_matcher.extract(normalized_query),
        slot_extractor.extract(normalized_query),
    )
    validate_slot_schema(slots)
    trace["slots"] = slots

    # 3. 别名、完整名、前缀和可选语义通道只负责找候选。
    candidates = item_repository.recall_candidates(
        mention=slots.skin_name,
        weapon=slots.weapon,
        limit=CANDIDATE_LIMIT,
    )
    trace["recalled_candidate_ids"] = ids(candidates)

    if not candidates:
        return result(
            status="NOT_FOUND",
            clarification="没有找到对应饰品,请提供更完整的武器和饰品名称",
            trace=trace,
        )

    # 4. 磨损、品质、多普勒阶段等是硬约束,不能被语义相似度覆盖。
    filtered, rejected = apply_hard_constraints(
        candidates,
        exterior=slots.exterior,
        quality=slots.quality,
        phase=slots.phase,
        tradable=slots.tradable,
    )
    trace["rejected_candidates"] = rejected

    if not filtered:
        return result(
            status="NOT_FOUND",
            clarification="找到饰品名,但没有匹配该磨损、品质或阶段的商品",
            trace=trace,
        )

    ranked = rank_candidates(
        filtered,
        exact_name=slots.skin_name,
        matched_aliases=slots.matched_aliases,
        slot_completeness=slots.completeness,
    )
    best = ranked[0]
    second = ranked[1] if len(ranked) > 1 else None

    # 5. 候选不唯一、缺关键槽位或分差太小时必须澄清。
    if has_required_slot_missing(slots) or best.score < MIN_SCORE:
        return ambiguous_result(ranked, missing_slots(slots), trace)
    if second and (best.score - second.score) < MIN_SCORE_MARGIN:
        return ambiguous_result(ranked, distinguishing_slots(best, second), trace)

    # 6. 最终 ID 和 market_hash_name 只从权威业务表读取。
    item = item_repository.get_enabled_by_canonical_id(best.canonical_id)
    authorize(principal, action="market:read", resource=item)

    return result(
        status="RESOLVED",
        skin_id=item.skin_id,          # 若真实 Schema 使用该字段
        canonical_id=item.canonical_id,
        market_hash_name=item.market_hash_name,
        matched_aliases=slots.matched_aliases,
        confidence="HIGH",
        trace=trace,
)伪代码中的 MIN_SCORE、MIN_SCORE_MARGIN 和必填槽位不应凭经验固定;应用已标注的精确名、别名、错别字、缺磨损、StatTrak/纪念品、多普勒阶段和未知饰品问题集做校准,同时报告实体识别 Recall、链接准确率、错绑率、澄清率和未知实体拒识率。
推荐的最小数据结构是:
text
skin_item(
  canonical_id PRIMARY KEY, market_hash_name UNIQUE,
  weapon, skin_name, exterior, quality, phase, enabled
)
skin_alias(alias_normalized, canonical_id, alias_type, locale, priority)
source_item_mapping(platform, source_item_id, canonical_id, status, version)如果真实业务表将 canonical_id 命名为 skin_id,只替换字段名,不改变上述身份边界。
返回对象不应只有两个 ID,还要携带解析状态和证据:
json
{
  "status": "RESOLVED",
  "mention": "久经普通龙狙",
  "skin_id": "<从业务库读取>",
  "market_hash_name": "AWP | Dragon Lore (Field-Tested)",
  "matched_aliases": ["龙狙", "久经"],
  "confidence": "HIGH",
  "missing_slots": []
}如果用户只说“龙狙多少钱”,由于磨损与品质未确定,应返回 AMBIGUOUS 并追问,不应产生任意 skin_id。
- 考察点| 业务数据建模。
- 加分项| 说明抽取与链接的区别,以及改名、脏数据、低置信澄清和跨平台映射。
- 高频误区| 用中文名称做唯一键;让 LLM 直接编造
market_hash_name/skin_id;将用户资产与市场模板混为一个身份。 - 下一问| “龙狙多少钱”同时命中多个磨损和品质候选时,你怎样设计置信度、分差阈值与澄清交互?
Q26|多源行情聚合怎样处理延迟、冲突和异常值?
项目化回答: 每条报价保留来源、采集时间、币种、手续费和可交易性,先规范化再聚合。对过期、异常跳变、样本不足和来源故障分别处理,最终价格必须可追溯到原始快照;聚合规则由业务目标和实测决定,不能直接对各平台价格取平均。
- 考察点| 多源聚合经验。
- 加分项| 置信度、熔断和回放验证。
- 高频误区| 直接对平台价格取平均。
- 下一问| 某平台低价但无法成交,是否应进入估值?
Q27|RabbitMQ 与 Kafka 在你的项目中怎样选?
项目化回答: RabbitMQ 更适合复杂路由、任务队列和延迟消息,Kafka 更适合高吞吐事件流、可回放日志和多消费者订阅。选择要看顺序、重放、堆积、延迟、消费模型和运维,不按“谁性能更高”简单判断;消息默认按至少一次投递设计,消费者用业务幂等键去重,生产者用 Outbox 或事务消息避免提交后丢事件。
- 考察点| 消息中间件选型与可靠性实践。
- 加分项| 说明 DLQ、重试主题和消息保留。
- 高频误区| 认为 MQ 能自动保证业务恰好一次。
- 下一问| 视频任务队列和行情事件流分别选什么?消费成功但确认消息失败会发生什么?
Q28|MySQL、Redis、MongoDB、ClickHouse 分别适合你简历中的哪些数据?
项目化回答: MySQL 存交易与权威业务状态,Redis 存热点和短期协调数据,MongoDB 适合模式灵活的行为记录,ClickHouse 适合分析型明细与聚合查询。选择还要说明一致性、更新模式、查询模式和运维边界;简历中的用户行为日志、行情快照和数仓大宽表正好对应不同存储。
- 考察点| 存储选型是否按数据语义进行。
- 加分项| 说明 Redis 失效、ClickHouse 去重和数据回补。
- 高频误区| 把 Redis 当权威数据库。
- 下一问| 实时行情缓存穿透或热 Key 怎么处理?
Q29|稳销云系统的多租户授权和线索同步怎么设计?
项目化回答: 百度、腾讯、字节媒体线索对接要解决多租户快捷授权、Pull/Push 同步和幂等:授权令牌按租户隔离存储与刷新,同步任务用事件和延迟队列解耦,公海自动回流与 SOP 全流程监控通过状态机和审计日志保证可追踪。结合 OpenAI 的客户画像分析要说明埋点数据如何动态调整 Prompt,以及如何评测画像准确性。
- 考察点| 历史项目中的 AI 与多租户工程实践。
- 加分项| 说明线索去重、回调丢失和授权过期的处理。
- 高频误区| 只讲“对接了媒体平台”。
- 下一问| 客户画像的准确性用什么指标评测?
10. 项目真实性、协作与复盘
Q30|最近几个项目中,你亲自负责的边界分别是什么?
项目化回答: 我会分别说明需求决策、架构、核心代码、联调、上线和运营中由我负责的部分,并给出
[代码路径/提交/设计文档/Trace/评审记录]。团队完成的模型、平台或业务结果要明确归属,不使用“我们做了”替代个人贡献;哪个模块离开我仍能正常维护,也要如实说明。
- 考察点| 核验个人贡献,排除团队成果全部归己。
- 加分项| 说明一次自己主导的关键取舍。
- 高频误区| 项目越大,个人职责越模糊。
- 下一问| 哪个模块离开你仍能正常维护,为什么?
Q31|CSGO 饰品智能平台中,印象最深刻的问题和难点是什么?
项目化回答: 这个项目最让我印象深刻的,不是把大模型 API 接进来,而是让同一个问题中的稳定知识、精确饰品实体、实时行情和用户资产在正确的时间与权限边界内组合成一个答案。例如用户问“某款多普勒饰品现在值不值得买”,刀型、外观、阶段和磨损是需要消歧的精确实体,影响价格的规则属于稳定知识,而“现在”的在售价、求购价和库存必须来自受控实时接口。如果全部走向量检索,很可能“语义相似但实体不对”,或把历史价格当成当前价格;如果只查实时接口,又缺少判断依据和可追溯引用。
我把这个问题拆成四层。第一层是饰品身份:市场模板、行情快照和用户资产分层建模,不用中文展示名当唯一键。第二层是证据路由:稳定知识走 BM25/Sparse 与 Dense 混合召回、RRF 融合和 Rerank,当前价格、库存和近期成交走受控只读工具。第三层是证据合并:统一保留来源、币种、观测时间、快照或版本,发生冲突时以实时业务源处理当前事实,证据不足时澄清或拒答。第四层是可观测与验证:用
request_id串起原始/改写 Query、权限过滤、各通道候选、Rerank、final_context、工具耗时、数据时间和降级原因,再用固定问题集和接口超时、权限不足、数据过期等故障用例做回归。这个难点让我形成的可复用经验是:RAG 解决的是“找到可引用的知识证据”,不是提供业务实时真值;模型负责理解和组织,权限、时效、状态和失败降级必须由确定性工程系统控制。当前可证明的是方案、本地小规模检索实验和故障验证;没有脱敏线上事故 Trace 时,我不会把它包装成已发生的生产事故。
- 考察点| 能否把业务实体、时间语义、RAG、工具调用、权限、降级和评测串成真实的工程闭环。
- 加分项| 现场画出知识/实时双通道,展示一条脱敏 Trace 或 Evidence Schema,并说明 Reranker 只能重排已召回候选、不能补回漏召回证据。
- 高频误区| 只说“调 Chunk Size、Top-k 和 Prompt”;把小规模本地实验说成线上效果;没有真实事故却编造现象和收益。
- 下一问| 实时行情接口超时,但 RAG 知识检索成功时,你怎样组织降级答案?
Q32|这份简历中你认为最容易被质疑的三处是什么?
项目化回答: 最容易被追问的是 Agent 是否真正具有动态决策、RAG 是否有评测与权限证据、AI 视频和模型网关的成本与稳定性是否有数据。我的准备方式不是再加名词,而是为每处补一张调用链、一条 Trace、一组指标和明确个人贡献;暂时补不出的就收缩表述,例如把“实现了”改成“设计了”。
- 考察点| 自我认知与证据准备。
- 加分项| 给出具体删改或补证计划。
- 高频误区| 回答“没有明显问题”。
- 下一问| 如果今天只能删掉简历中的一个强声明,你删哪个?
Q33|如果入职后 30 天让你接手一个现有 Agent 系统,你会怎么做?
项目化回答: 先梳理业务目标、权限和 SLO,再选一批真实任务回放,建立从输入到工具结果的 Trace。随后按高风险副作用、不可恢复状态、无评测集、无版本和成本失控排序整改,先补最小安全与观测闭环,再谈功能扩张;给出 7、14、30 天阶段交付,不第一周就更换框架或模型。
- 考察点| 落地优先级和接管能力。
- 加分项| 明确什么情况会立即暂停线上 Agent。
- 高频误区| 第一周就更换框架或模型。
- 下一问| 什么情况会让你立即暂停线上 Agent?
11. 数据指标与量化追问
面试官问指标,不只是要一个数字,而是在核对“是否真的测过、能否解释变化、是否知道代价”。统一使用下面的六段式回答:
指标定义与公式 → 样本、窗口、版本和分桶 → 基线与当前值 → Trace 拆解与根因 → 本人优化动作与增量 → 未解决问题、权衡和下一步
如果没有真实数字,可以使用明确标注的模拟行业基准训练表达,但不能把行业参考值、测试环境结果或建议目标冒充线上数据。至少准备以下三张脱敏证据卡:
| 指标卡 | 必填口径 | 项目分桶 | 最小证据 |
|---|---|---|---|
| RAG 检索 | Recall@K、MRR/NDCG、最终 Context Precision、引用支持率 | 知识问答/专有名词/实时行情误路由/权限与有效期 | 固定标注集、候选与 Rerank Trace、失败样本桶、消融对比 |
| 首 Token 延迟 | first_token_at - gateway_received_at,同时报 P50/P95 | RAG 路径/实时工具路径、冷/热请求、模型与版本 | 阶段耗时 Trace、请求量、统计窗口、超时与降级记录 |
| 单次 Query 成本 | 模型、Embedding、Rerank、工具基础设施、重试费用 / 成功 Query 数 | 意图、模型、租户、输入长度、成功/失败/重试 | 输入/缓存/输出 Token、账单、重试次数、质量护栏 |
模拟行业基准,不是简历实测: 以下数字模拟一个中等规模垂直领域 RAG:约 12 万个子 Chunk、1,000 条固定标注问题、每月 10 万个成功 Query,70% 知识 RAG、20% 实时工具、10% 复杂 Agent;生成模型使用
gpt-5.6-terra、流式响应和中低推理强度。经验参考区间设为 Recall@2088%~95%、TTFT P501~2 秒、TTFT P952.5~4.5 秒、单次输入3,000~8,000 Token、输出300~800 Token、完全成本$0.01~$0.05/成功 Query。这些是面试演练区间,不是权威行业统计。
Q34|你们的召回准确率是多少,怎样提高,为什么没有达到 100%?
项目化回答: 我先纠正一下口径,召回阶段不使用一个模糊的“准确率”,我主要看必要证据的 Recall@K,排序质量看 MRR 或 NDCG,进入最终上下文后再看 Precision 和引用支持率。在 CSGO 饰品智能平台的模拟基准中,我使用 1,000 条固定标注问题,Dense-only 基线的 Recall@20 是
82.4%、MRR@10 是0.682、NDCG@5 是0.714;加入实体和饰品别名归一后 Recall@20 到85.6%,父子 Chunk 后到87.7%,BM25/Sparse 与 Dense 双路召回加 RRF 后,Recall@20 到92.7%、MRR@10 到0.811。Cross-Encoder 不能补回未召回证据,主要把 NDCG@5 提高到0.842,最终 Context Precision@5 为78.9%,引用支持率为93.4%。剩余 73 条漏召回中,知识缺失或过期 21 条、表格解析丢结构 14 条、Query/实体歧义 13 条、ACL/有效期过滤 9 条、Embedding/ANN 长尾 10 条、标注噪声 6 条。100% 不是孤立优化目标:无限增大 TopK 会降低 Precision、增加 TTFT 和 Token;证据不足或高风险时应澄清、拒答或转实时工具。这组数值用于面试模拟,不能表述成真实线上结果。
指标追问的 60~90 秒口述: 这四个指标对应的是同一条 RAG 漏斗。以“磨损值为什么影响饰品价格”这类知识问题为例,我先为每条问题标注必要证据 ID 和相关等级。BM25/Sparse 与 Dense 双路召回的 Top20 用 Recall@20 评估,它达到
92.7%,说明候选层平均找回了约 92.7% 的必要证据;融合和排序后的 Top10 用 MRR@10 评估,0.811说明第一条正确证据通常很靠前,但它不代表后续证据完整;精排后的前五名用 NDCG@5 评估,0.842说明高相关证据的整体顺序较接近理想排序;最后经过父块回填、去重和 Token 截断,真正交给模型的五块 Context Precision@5 是78.9%,也就是平均约四块真正支持回答。四个指标一起看,才能区分问题是在召回、排序还是上下文拼装层;最终还要用引用支持率、答案正确性、TTFT 和成本做端到端护栏。指标定义与计算边界见 RAG 评测与生产工程。
如果面试官追问“你怎么计算”: 我会说明评测集固定为 1,000 条带
gold_chunk_ids、相关等级、Query 类型和版本信息的问题;每次实验保存各通道候选、融合排名、Rerank 分数与final_context_ids,按问题先算单题指标再做 Macro Average,并按精确实体、同义问法、多跳、时效和权限过滤分桶。多证据问题如果要求全部证据同时命中,我会另报AllEvidenceHit@20,不把它和标准 Recall 混用。
- 考察点| 指标口径、评测集、消融归因和质量—延迟—成本权衡。
- 加分项| 区分
k_recall、k_rerank、k_context,并说明正确证据在哪一层首次消失。 - 高频误区| 把答案准确率当召回率;只报“提升到 90%”;用增大 TopK 掩盖语料或过滤问题。
- 下一问| Recall@20 提升但最终回答变差,你怎样判断是精排、Context 还是生成问题?
Q35|首 Token 响应时长是多少,为什么慢,卡点在哪里,怎样优化?
项目化回答: 我把首 Token 延迟定义为网关收到请求到客户端收到第一个流式 Token 的时间。在 30 天、10 万个成功 Query 的模拟窗口中,优化前 TTFT P50 是
2.05 秒、P95 是4.10 秒;优化后 P50 是1.42 秒、P95 是2.86 秒,分别下降30.7%和30.2%。我用同一request_id拆关键路径,优化后 P50 包含鉴权与路由 45ms、Query 改写与实体识别 105ms、混合召回 135ms、RRF 与 Cross-Encoder 245ms、Context 构造 90ms、模型排队与 Prefill 720ms、首个流式事件网络传输 80ms,主要卡点是模型排队与 Prefill,其次是精排。我的优化包括并行稀疏/稠密召回、缓存 Query Embedding、给 Rerank 设置 Deadline 并降级到 RRF、父块去重与动态截断、连接复用、模型预热和健康路由;同时确认 Recall@20 仍为92.7%、引用支持率为93.4%。TTFT 只表示开始响应,不等于完整回答已结束;这组数值同样是面试模拟基准。
- 考察点| 延迟定义、分位数、关键路径拆解和可验证优化。
- 加分项| 区分 TTFT 与端到端时长,说明排队、Prefill、Decode 分别影响什么。
- 高频误区| 只说“模型慢”;只报平均延迟;把开始流式输出误当整个请求已经完成。
- 下一问| 降低 Context Token 后 TTFT 变快但引用遗漏,如何重新分配检索和生成预算?
Q36|平均一次 Query 消耗多少 Token、花费多少,为什么高,怎样节省?
项目化回答: 我不会只报供应商单价,而是按“成功解决一次请求”核算模型、检索、工具、基础设施和失败重试的完全成本。模拟系统使用
gpt-5.6-terra:平均输入4,600 Token,其中未缓存3,000、缓存1,600,平均输出420 Token;按 2026-08-20 官方单价$2/百万输入 Token、$0.20/百万缓存输入 Token、$12/百万输出 Token,模型成本是$0.01136/Query。再加 Embedding、Rerank、存储、网络和重试摊销$0.00244,完全成本为$0.0138/成功 Query,P95 为$0.031;按演练固定汇率1 美元=7.20 元,约为平均0.10 元、P950.22 元。优化前平均输入6,800 Token、输出520 Token、完全成本$0.0226,通过意图路由、父块和候选去重、Context/输出预算、稳定前缀 Prompt Cache、带 ACL 与版本键的结果缓存、增量 Embedding、模型分层和 Retry Budget,单位成功成本下降38.9%。降本后 Recall@20、引用支持率和 TTFT 没有越过护栏;价格会变化,真实项目必须按当前模型账单重算。这些金额是面试模拟,不是简历实付账单。
- 考察点| 成本归因、Token 观测、路由缓存和质量护栏。
- 加分项| 同时报平均值、P95 和单位成功成本,区分 Prompt Cache、结果缓存与缩短 Context。
- 高频误区| 只算输出 Token;把降低模型账单等同于降低总成本;成本下降但重试和人工返工上升。
- 下一问| 缓存命中率提高后,如何防止旧行情、旧权限或旧知识版本被错误复用?
12. 自测与评分
- [ ] 每题先只看问题,在 30 秒内给出结论,再核对答案;
- [ ] 用“业务目标 → 决策 → 为什么不选更简单方案 → 验证 → 证据边界”口述,不用“我们做了”代替个人贡献;
- [ ] 每个
[待补]都有一份真实材料可替换:一条 Trace、一个 Schema、一组指标或一段代码; - [ ] 按准确性、原理深度、工程意识、项目表达、沟通结构五个维度各打 0~5 分,任一 P0 题“项目证据”低于 3 分就优先补材料;
- [ ] 用一条真实 Trace 串联 RAG、模型网关或 Agent 的连续追问;
- [ ] 未确认的指标明确标注为“模拟行业基准”或“设计/演练”,不声称是线上实测。
- [ ] Recall、TTFT 和成本各有一张证据卡,包含公式、样本、窗口、版本、分桶、基线、当前值、失败样本,以及“实测/模拟”标签。
13. 事实边界与参考资料
- 单一事实源:简历
curriculum_vitae/王佳鹏简历20260724.docx与curriculum_vitae/王佳鹏简历-AI-Agent应用工程师面试题.md; - RAG、Agent、模型网关与视频工作流的通用机制见 专项题库 与 生产级 AI 应用连环追问专题;
- BGE-M3 的 Dense、Sparse 与 Multi-Vector 能力见 BGE M3-Embedding 论文,访问日期:2026-08-20;
- Milvus 的 BM25/稀疏全文检索能力见 Milvus Full Text Search,访问日期:2026-08-20;
- MCP 只提供协议与传输授权框架,工具仍需业务级鉴权和用户控制,见 MCP Authorization,访问日期:2026-08-20;
- Redis 可配置 RDB、AOF、两者组合或不持久化,任务状态能否恢复取决于部署与数据模型,见 Redis Persistence,访问日期:2026-08-20;
- ReAct 通过交替生成推理轨迹和任务动作,并用外部 Observation 更新后续决策,见 ReAct 论文,访问日期:2026-08-20;
- Plan-and-Execute 把复杂任务的全局规划与步骤执行分开,通常以更多模型调用换取长任务的计划完整性,见 LangChain Plan-and-Execute Agents,访问日期:2026-08-20;
- GPT-5.6 Terra 的输入、缓存输入和输出 Token 单价见 OpenAI GPT-5.6 Terra,访问日期:2026-08-20;
- OpenAI 官方建议通过精简重复指令、减少无关工具、控制推理强度并用代表性 Evals 验证 Token、延迟和成本变化,见 OpenAI Model guidance,访问日期:2026-08-20;
- 涉及动态 API、模型版本、价格与能力时,按目标供应商、模型、区域和版本核对官方文档并记录访问日期;
- 项目数字、版本能力和业务收益必须来自实测或可定位证据,不能编造。
当前无法确认| 简历未提供的模型 ID、框架版本、向量库、数据规模、QPS、延迟、准确率、成本变化、线上故障记录和个人代码占比;无证据时全部以
[待补]或“设计/演练”表达。
14. 总结
一句话记忆: 这份简历的面试核心不是证明“知道很多 AI 名词”,而是证明能把 Agent、RAG、视频和模型网关做成可控、可恢复、可评测、可追责的生产系统。
- 九年后端经验通过状态、一致性、异步可靠性和可观测性体现,而不是只报工作年限;
- CSGO Agent 采用任务级 Plan-and-Execute 与步骤级 ReAct Executor 的组合模式;上下文丢失时按会话指代、RAG 证据、任务 Checkpoint 和实时快照分层恢复,同时讲清 Plan Version、Observation、Replan、控制权、工具 Schema、Memory、终止、权限和过程评测;
- RAG 必须讲到数据治理、ACL、混合召回、分阶段 K、最终 Context、实时 API 和引用评测;
- AI 视频与模型网关的强声明必须用状态机、Trace、失败样本、成本公式和个人贡献支撑;
- 数据指标统一按“口径、样本与窗口、基线与当前值、阶段归因、本人动作、剩余边界”回答;无法从真实代码、数据或记录证明的数字标记为设计或待补证据,并相应收缩简历表述。