外观
Python Web后端岗位定向面试准备快问快答版
30 秒结论| 这份速答版围绕“对象和值语义、函数与协议、运行时与并发、Web 与测试”四条主线整理 36 道 Python 高频题。每题先记关键词,再用“结论 → 机制 → 边界”口述 20~30 秒,说完即停;完整原理、项目题、MySQL、Redis、Docker 和系统设计见完整岗位准备。
目录
1. 使用说明
把面试想成“打乒乓球”,第一板只需要把结论准确地回过去,不必一口气讲完整章教材。面试官继续追问时,再补源码机制、代码示例和项目证据。
每题按下面三句话回答:
第一句:它是什么或我的结论 → 第二句:核心机制或实现 → 第三句:适用边界、风险或验证方式
练习规则:
- 看题后 3 秒内说出关键词;
- 20~30 秒完成主回答;
- 主动停住,不抢答追问;
- 不会的题标记,不用含糊术语掩盖;
- 项目题只讲本人能证明的代码、日志、配置或指标。
2. Python 快答路线
图:Python 薄弱项递进补强路径
替代文本: 从 Python 对象和值语义出发,依次掌握函数与协议、解释器运行时、并发异步,最后落到 Web 请求链、部署和测试;每层都通过最小代码实验与口述复盘形成证据。
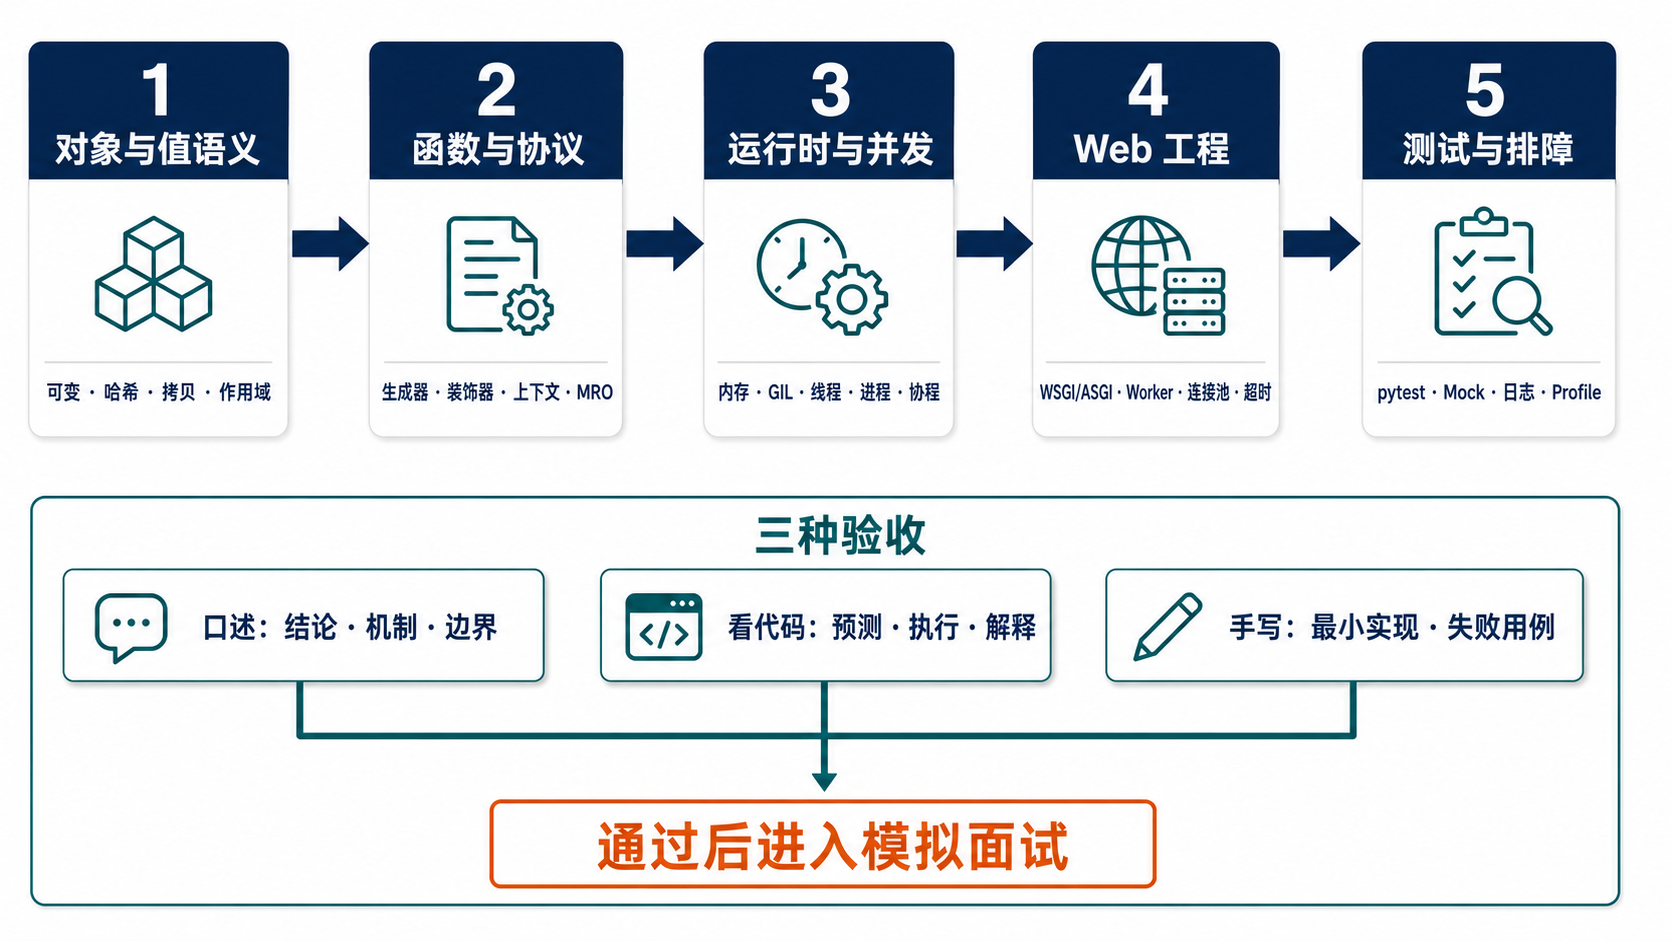
读图结论: 不要从背框架 API 开始;先把对象、函数和运行时讲清,再理解并发与 Web,知识才不会在追问中断层。
图片中的“对象和值语义”是地基,“函数与协议”决定能否写出符合 Python 风格的代码,“运行时与并发”决定性能判断是否准确,“Web 与测试”负责把语言能力转化为可交付服务。类比只说明学习顺序,真实项目还要结合框架版本、依赖类型和部署拓扑验证。
3. 对象与值语义
Q01|is 和 == 有什么区别?
关键词| 对象身份 · 值相等 · None
20 秒口述:
is比较两个引用是否指向同一个对象,==调用相等性协议比较值是否相等。判断None应用is None;不能依赖小整数或字符串驻留现象,用is比较业务值。
Q02|可变对象和不可变对象怎么理解?
关键词| 原地修改 · 新对象 · 共享引用
20 秒口述: 可变对象能在身份不变时修改内部状态,例如
list和dict;不可变对象的“修改”会得到新对象,例如int、str和tuple。真正的风险是多个变量共享同一个可变对象,所以接口边界要避免意外修改。
Q03|list、tuple、set、dict 怎么选?
关键词| 有序序列 · 不可变语义 · 去重 · 键值映射
20 秒口述: 有顺序且需要修改用
list,表达固定记录或不可变序列可用tuple,去重和成员判断用set,按键查值用dict。选择依据是数据语义和操作模式,不是简单背“谁更快”。
Q04|什么对象可以作为 dict 的键?
关键词| Hashable · 哈希稳定 · __eq__
20 秒口述: 字典键必须可哈希,也就是生命周期内哈希值稳定,并且相等对象必须有相同哈希。
str、int和只含可哈希元素的tuple通常可以,list、dict、set不行,因为内容变化会破坏哈希表定位。
Q05|浅拷贝和深拷贝有什么区别?
关键词| 外层容器 · 嵌套对象 · 共享状态
20 秒口述: 浅拷贝只创建新的外层容器,内部嵌套对象仍共享;深拷贝会递归复制对象图。深拷贝不是默认更安全,它成本更高,也可能遇到不可复制资源或循环引用;应先明确哪些层需要隔离。
Q06|为什么可变对象不能直接作默认参数?
关键词| 定义时求值 · 跨调用复用 · None 哨兵
20 秒口述: 函数默认参数在定义函数时求值一次,不是每次调用都重新创建,因此用空列表作默认值会在多次调用之间共享状态。常见写法是默认设为
None,进入函数后再创建新对象。
Q07|[[0] * 3] * 2 有什么坑?
关键词| 重复引用 · 同一行对象 · 列表推导
20 秒口述: 外层乘法复制的是同一个内层列表的引用,修改一行会让多行一起变化。需要独立行时应写
[[0] * 3 for _ in range(2)];这类题考的是对象引用,不是列表乘法语法。
Q08|Python 参数传递是值传递还是引用传递?
关键词| 对象引用传递 · 重新绑定 · 原地修改
20 秒口述: 更准确的说法是“对象引用按值传递”:形参拿到的是对象引用的一份副本。函数内重新绑定形参不会改变调用方变量,但对共享可变对象做原地修改,调用方可以观察到。
Q09|a += b 和 a = a + b 一定相同吗?
关键词| 原地协议 · 新对象 · 可变与不可变
20 秒口述: 不一定。
+=会优先尝试原地加法协议,可变对象可能保持身份并修改自身;a = a + b通常先创建结果再重新绑定。对不可变对象两者效果常相近,但不能把这个经验泛化到所有类型。
4. 函数与 Python 协议
Q10|Python 的 LEGB 查找规则是什么?
关键词| Local · Enclosing · Global · Built-in
20 秒口述: 名字按 Local、Enclosing、Global、Built-in 的顺序查找。函数体内只要出现赋值,名字默认就是局部变量;需要修改外层函数或模块变量时分别使用
nonlocal或global,但工程中应减少隐式共享状态。
Q11|闭包的晚绑定问题是什么?
关键词| 自由变量 · 调用时查找 · 默认参数冻结
20 秒口述: 闭包捕获的是变量,不是创建闭包那一刻的值,所以循环生成函数时,最后调用可能都读到循环变量的最终值。可以用默认参数或工厂函数在每轮冻结当前值。
Q12|*args、**kwargs 和 keyword-only 参数分别解决什么?
关键词| 位置参数 · 关键字参数 · 接口约束
20 秒口述:
*args收集额外位置参数,**kwargs收集额外关键字参数;参数列表中*后面的参数只能按关键字传递。生产接口中 keyword-only 能减少调用歧义,**kwargs则不能成为随意吞掉错误参数的借口。
Q13|Iterable、Iterator 和 Generator 有什么区别?
关键词| __iter__ · __next__ · yield
20 秒口述: Iterable 表示能产生迭代器,Iterator 还实现
__next__并保存遍历状态,Generator 是用yield创建迭代器的一种便捷方式。生成器通常只能消费一次,优势是惰性计算,代价是状态和资源生命周期更隐蔽。
Q14|yield 和 return 有什么区别?
关键词| 暂停恢复 · 惰性产出 · 终止函数
20 秒口述:
return返回结果并结束本次函数调用,yield产出一个值后保存执行现场,下次迭代再继续。它适合流式处理和大数据逐条消费,但异常、关闭和底层资源释放必须显式考虑。
Q15|装饰器的本质是什么?
关键词| 高阶函数 · 包装替换 · functools.wraps
20 秒口述: 装饰器本质是接收函数或类并返回替代对象,常用于日志、鉴权、缓存和重试等横切逻辑。函数装饰器通常用
functools.wraps保留元数据,同时必须处理参数、返回值、异常以及同步异步边界。
Q16|装饰器怎样同时兼容同步和异步函数?
关键词| 可等待对象 · inspect.iscoroutinefunction · 分支包装
20 秒口述: 不能用普通同步包装器直接包异步函数,否则可能只返回协程而没有正确等待。可以检测被装饰函数是否是 coroutine function,分别返回
async def和普通def包装器,并在两条路径上保持一致的异常和日志语义。
Q17|上下文管理器解决什么问题?
关键词| with · 获取与释放 · 异常路径
20 秒口述: 上下文管理器把资源获取和释放绑定到一个明确作用域,即使中间抛异常也会执行退出逻辑。它可通过
__enter__/__exit__或contextmanager实现,常用于文件、锁、数据库事务和连接。
Q18|try/except/else/finally 的执行顺序是什么?
关键词| 精确捕获 · 成功分支 · 必执行清理
20 秒口述:
try执行受保护代码,匹配异常时进入except,没有异常才执行else,finally无论是否异常通常都会执行。应捕获足够具体的异常,不用裸except隐藏程序错误,清理资源优先交给上下文管理器。
Q19|MRO 和 super() 是怎么工作的?
关键词| C3 线性化 · 协作式继承 · 下一节点
20 秒口述: MRO 是多继承时的方法查找顺序,Python 使用 C3 线性化保证局部优先级和单调性。
super()不是简单调用父类,而是沿当前 MRO 调用下一个实现,所以协作式多继承要求各层签名兼容并继续调用super()。
Q20|__new__ 和 __init__ 有什么区别?
关键词| 创建实例 · 初始化实例 · 不可变类型
20 秒口述:
__new__负责创建并返回实例,__init__在实例创建后负责初始化且不能返回其他对象。普通业务类几乎只需__init__;定制不可变类型、元类或实例创建流程时才常重写__new__。
Q21|property 和 descriptor 有什么关系?
关键词| 属性访问协议 · __get__ · 数据描述符
20 秒口述: Descriptor 是通过
__get__、__set__或__delete__接管属性访问的协议,property是常用的数据描述符。ORM 字段、校验字段等会使用它,但项目中应优先选择可读的普通属性或property,避免为了技巧增加复杂度。
5. 运行时与并发
Q22|CPython 如何管理内存?
关键词| 引用计数 · 循环垃圾回收 · 分配器
20 秒口述: CPython 主要靠引用计数及时回收对象,再用循环垃圾回收处理容器形成的引用环,并通过自己的内存分配器管理小对象。内存占用高不等于一定泄漏,还要区分对象仍被引用、缓存、碎片和 C 扩展资源。
Q23|GIL 是什么,它影响什么?
关键词| CPython · 字节码互斥 · CPU 密集
20 秒口述: 在常见 CPython 运行模式下,GIL 让同一进程内通常只有一个线程执行 Python 字节码,所以纯 Python CPU 密集任务难以靠多线程获得多核并行。I/O 等待时线程仍可并发,CPU 密集任务可考虑多进程、原生扩展或独立计算服务。
Q24|有 GIL 是否就不需要加锁?
关键词| 非原子复合操作 · 共享状态 · 外部资源
20 秒口述: 不需要加锁是错误结论。GIL 只约束解释器字节码执行,不保证一组业务操作原子,也不保护数据库、文件或跨进程状态;共享可变数据仍需锁、队列、事务或避免共享的设计。
Q25|进程、线程、协程分别适合什么场景?
关键词| CPU 并行 · 阻塞 I/O · 高并发 I/O
20 秒口述: 进程隔离强、可利用多核,适合 CPU 密集;线程适合已有阻塞库和中等规模 I/O;协程以较低切换成本承载大量 I/O 并发。选择还要看依赖是否异步、隔离需求、调试成本和故障影响范围。
Q26|Coroutine、Task 和 Future 有什么区别?
关键词| 可等待计算 · 调度执行 · 结果占位
20 秒口述: 调用
async def得到 coroutine,它描述尚未完成的异步计算;Task 把 coroutine 注册到事件循环中并负责调度;Future 表示未来会产生结果的低层占位对象。业务代码通常操作 coroutine 和 Task,框架在底层对接 Future。
Q27|await f() 和 create_task(f()) 有什么区别?
关键词| 顺序等待 · 并发调度 · 生命周期管理
20 秒口述: 直接
await会等待该操作完成后再继续,create_task让任务先进入调度,从而与后续异步工作并发。创建 Task 后必须保存引用、收集结果和异常,并处理取消,不能把它当成无管理的后台线程。
Q28|Event Loop 如何工作?
关键词| 就绪队列 · I/O 多路复用 · 协作式调度
20 秒口述: Event Loop 运行就绪回调和 Task;遇到未就绪 I/O 时,协程通过
await交还控制权,循环借助 epoll 或 kqueue 等机制等待事件,再恢复对应任务。它是协作式调度,因此任何长时间同步阻塞都会拖慢整个循环。
Q29|异步函数里调用阻塞 SDK 会怎样处理?
关键词| 阻塞事件循环 · 异步客户端 · 线程池隔离
20 秒口述: 阻塞 SDK 会占住事件循环线程,导致其他请求一起延迟。优先换成真正的异步客户端;无法替换时可用
asyncio.to_thread或受控线程池隔离,同时设置超时、并发上限和观测,不能无限把阻塞调用扔进线程池。
Q30|异步任务怎样处理超时和取消?
关键词| Deadline · 传播取消 · 清理资源
20 秒口述: 我会使用端到端 Deadline,把剩余预算传给下游;超时后取消任务,并让
CancelledError正确传播,同时在finally或上下文管理器中释放资源。若底层操作不可取消,还要限制并发并对最终结果做对账。
Q31|ThreadPoolExecutor 和 ProcessPoolExecutor 怎么选?
关键词| 阻塞 I/O · CPU 密集 · 序列化成本
20 秒口述: ThreadPool 适合包装阻塞 I/O 或会释放 GIL 的调用,共享内存方便但要防竞态;ProcessPool 适合可序列化的 CPU 密集任务,能用多核,但有进程启动、数据拷贝和故障隔离成本。应以任务类型和基准测试选型。
6. Web 框架、部署与测试
Q32|Django、Flask、FastAPI 怎么选?
关键词| 完整生态 · 轻量灵活 · 类型与 ASGI · 团队约束
20 秒口述: Django 内置 ORM、后台和权限等完整能力,适合管理系统和规范化团队;Flask 核心轻量,适合边界清晰的小服务,但扩展治理由团队承担;FastAPI 以类型标注和 ASGI 见长,适合 API 与异步 I/O。选型看业务复杂度、存量生态和团队经验,不只看跑分。
Q33|WSGI 和 ASGI 有什么区别?
关键词| 同步请求 · 异步事件 · 长连接
20 秒口述: WSGI 主要定义同步 HTTP 应用与服务器的接口,生态成熟;ASGI 支持异步请求、WebSocket 和生命周期事件。ASGI 只提供并发基础,如果数据库驱动或业务代码仍同步阻塞,换协议不会自动获得高并发。
Q34|一个 HTTP 请求进入 Python Web 服务后经过哪些环节?
关键词| Nginx · Worker · 中间件 · 路由 · ORM · 响应
20 秒口述: 请求通常先经负载均衡或 Nginx,再到 Gunicorn、uWSGI 或 ASGI Server 的 Worker,随后经过中间件、路由、视图或 Service、ORM 与外部依赖,最后序列化响应。排障时我会沿同一链路查看 request_id、耗时和错误边界。
Q35|什么是 ORM 的 N+1 问题?
关键词| 一次列表 · 每行再查 · 预加载 · 查询证据
20 秒口述: N+1 是先查询一批主对象,再为每个对象单独查询关联数据,导致查询次数随结果数量增长。Django 可按关系类型使用
select_related或prefetch_related;优化前后要用 SQL 日志、查询数和延迟验证,不能只凭代码猜测。
Q36|Python Web 项目怎样测试?
关键词| 单元测试 · 集成测试 · Fixture · Mock 边界
20 秒口述: 纯业务逻辑用单元测试覆盖边界和异常,数据库、缓存、消息与 HTTP 链路用集成测试验证真实契约,再补关键接口端到端测试。Fixture 管理可复用前置条件,Mock 只替换真正的外部边界;Mock 过多会让测试通过但真实集成失败。
7. 快速自测
完成一轮后按五个维度各打 5 分:
- 准确性: 是否有概念错误,是否把实现细节说成语言规范;
- 机制深度: 能否解释“为什么”,而不只背结论;
- 工程意识: 是否提到异常、资源、超时、并发和验证;
- 项目表达: 能否补一个真实使用或故障证据;
- 沟通结构: 是否 30 秒内收口,并给面试官留下追问入口。
推荐练习顺序:
- 第一轮只看题,能说出关键词即通过;
- 第二轮录音,删除“可能、大概、应该”等模糊表达;
- 第三轮随机抽 10 题,每题追问一次;
- 第四轮把 Q23~Q35 串成“并发请求为何变慢”的完整排障链。
8. 总结
一句话记忆: Python 面试先用“对象与协议”解释语言机制,再用“并发与请求链”证明自己能把代码稳定地运行在生产环境。
- Python 快答的地基是对象引用、可变性、作用域和协议,不是框架 API;
- 并发题必须同时讲任务类型、GIL、阻塞边界、超时取消和资源治理;
- Web 题要从请求链落到 ORM、Worker、日志和测试,不能只比较框架口号;
- 面试主回答控制在三句话,追问时再补代码实验和真实项目证据;
- 最值得先练的是 Q06、Q23~Q35,它们最容易暴露 Python 基础与生产经验的断层。